В декабре 2007 года команда Барака Обамы выбирала главное изображение на странице, куда попадали будущие сторонники. Сотрудникам нравилось видео,но проверка показала иное: все испытанные фотографии собирали регистрации лучше всех испытанных роликов. Победила фотография семьи и кнопка «Learn More». В эксперименте участвовали 310 382 посетителя; конверсия выигравшей комбинации составила 11,6% против 8,26% у исходной страницы. Позднее руководитель аналитики кампании Дэн Сирокер оценил возможный эффект этого решения на протяжении всей кампании в 60 млн долларов пожертвований. Оценка получена экстраполяцией результатов теста на дальнейшие регистрации и пожертвования. Источник: разбор Сирокера с методикой и расчётом.
Сотрудникам кампании нужно было принять одно решение: какую страницу оставить после проверки. Миллионы будущих посетителей увидели бы победившее сочетание. В этом и состояла привлекательность теста: спор о вкусе можно было закончить и продолжить работу.
Однако эксперимент отвечал на ограниченный вопрос: какое сочетание лучше работает на всей проверяемой аудитории? Из этого ещё не следовало, что оно лучше для каждого посетителя. Между «мы нашли удачную страницу» и «мы умеем выбирать удачную страницу для разных людей» оставалась целая область работы.
Персонализация развивалась рядом с экспериментами и отчасти раньше их массового распространения. Amazon училась подбирать товары, исследователи — рекомендовать тексты, позднее Netflix — собирать витрину фильмов для каждого зрителя. У этих систем появлялось всё больше способов сделать страницу разной. Проверять, становится ли она от этого полезнее, приходилось отдельно.
У сервисов экспериментов возникло понятное обещание: помочь команде принять решение. Персонализация требовала следующего шага — доверить программе часть решений, которые она будет принимать постоянно. Разница кажется небольшой, пока не выясняется, кто подготовит варианты, разрешит их показывать и ответит за результат. Из этой разницы выросли и коммерческие трудности персонализации, и способы сделать её востребованным продуктом.
#До кнопок и заголовков: как Amazon выбирала, что поставить рядом с книгой
Один из ранних путей к персонализации проходил через подбор содержимого. В 1994 году исследователи описали GroupLens, систему совместной фильтрации сообщений Usenet: пользователи оценивали тексты, система искала закономерности в оценках и помогала ориентироваться в огромном потоке. Для рекомендации не требовалось понимать текст так, как его понимает человек. Достаточно было обнаружить, что люди с похожими вкусами положительно оценивали похожие материалы. Исходная работа GroupLens, CSCW 1994.
В торговле задача стала сложнее. Посетитель открывает книгу, а магазин должен немедленно решить, что показать рядом. Поиск «похожих людей» для каждого визита плохо масштабировался: каталог и аудитория быстро росли. Команда Amazon развернула расчёт в другую сторону: заранее оценивать связи между товарами, а на странице посетителя доставать подходящие предметы из уже подготовленных связей. По ретроспективному описанию исследователей Amazon, компания запустила рекомендации item-to-item в 1998 году, а Грег Линден, Брент Смит и Джереми Йорк подробно изложили подход в статье 2003 года. Ретроспектива исследователей и история Amazon Science.
Важна тонкость: связь не равна простому числу совместных покупок. Если покупатели двух предметов пересекаются только потому, что один из них и так невероятно популярен, совет получится скучным. Исследователи Amazon сопоставляли вероятность купить товар в контексте другого товара с его обычной вероятностью покупки. Но спустя годы выяснилась ошибка даже в этой поправке: покупатели первого товара в среднем могут покупать вообще больше вещей, поэтому сравнивать их с усреднённым клиентом недостаточно. Брент Смит описывает последующую поправку на то, сколько покупает клиент, как крупное улучшение качества рекомендаций. Работающий алгоритм годами давал полезные рекомендации, хотя часть связей объяснялась покупательской активностью, которую он учитывал недостаточно точно. Ретроспектива Amazon Science.
Эта линия развивалась отдельно от кнопочных A/B-тестов. Рекомендательная система отвечает на вопрос «что показать», эксперимент — «помогает ли выбранное изменение». Если рекомендации чаще приводят к кликам, это ещё не доказывает дополнительных продаж: популярный товар могли купить и без блока. Для проверки нужен контроль и правильно выбранная цель.
В 2006 году Netflix запустил публичный Netflix Prize, соревнование по точности предсказания оценок фильмов. Участники улучшали точность на подготовленных данных. Сервису предстояло решить следующий вопрос: помогает ли более точный прогноз человеку выбрать фильм на реальной странице? Позднее Netflix отдельно проверял алгоритмы на пользователях в A/B-тестах. История Netflix Prize и описание платформы экспериментов Netflix.
#2007–2012: эксперимент выходит из лаборатории
Рекомендательный алгоритм внутри Amazon или Netflix опирался на собственную инженерную команду. Для распространения экспериментов среди гораздо более широкого круга компаний требовался инструмент, которым могла бы пользоваться команда сайта без разработки своей платформы. В кампании Обамы таким инструментом стал Google Website Optimizer. Команда проверяла 24 сочетания — четыре подписи кнопки и шесть визуальных материалов. Это был многовариантный эксперимент с распределением посетителей между комбинациями. Сирокер позже писал, что запуск был достаточно трудоёмким: после кампании он вместе с Питом Куменом основал Optimizely в 2010 году, чтобы сделать проверку страниц доступнее. Описание опыта.
Почему продукт с визуальным редактором оказался значимым? Раньше убедительная гипотеза часто застревала между маркетологом, разработчиком, релизным циклом и аналитиком. Конструктор вариантов сократил расстояние от «проверим другой заголовок» до показа двум случайным группам. Маркетолог получал возможность сам подготовить простое изменение и проверить его, сократив число обращений к разработчикам. Именно эта экономия работы делала статистический инструмент понятным продуктом.
Похожий вывод независимо сделал Парас Чопра. В 2009 году он построил первый Wingify как более широкий маркетинговый инструмент и показал его аудитории Hacker News. По воспоминаниям основателя, у продукта появились первые 15–20 пользователей, но ответ был неприятным: он пытался делать слишком многое, поэтому пользоваться было непонятно. Чопра оставил одну функцию — A/B-тест — и сделал для неё визуальный редактор. Так появился Visual Website Optimizer, позднее VWO. Он также приводит ранние коммерческие цифры: $4000 выручки за первый месяц платных планов, более $25 000 в месяц через восемь месяцев. Десятилетняя ретроспектива Чопры.
Был и другой маршрут: SiteSpect предложил проверять изменения ближе к серверу, через сетевой слой, не полагаясь целиком на изменение страницы браузерным скриптом. Такое внедрение требует более тесной работы с IT. Зато для большой компании открываются дополнительные возможности: можно экспериментировать с серверной логикой и уменьшить риск заметной посетителю подмены интерфейса после загрузки. В кейсе Trulia команда прямо объясняла интерес к серверной проверке тем, что браузерный скрипт мог ухудшить опыт на сайте. Команда, которой важен быстрый запуск нового заголовка, и команда, которая меняет работу крупного сервиса, предъявляют к одному слову «тестирование» разные требования. Документация SiteSpect об архитектуре.
Большие компании шли своим путём. Microsoft строила внутреннюю Experimentation Platform, изучая не только статистику, но и ошибки реализации, культуру принятия решений и способность команд признавать отрицательный результат. В обзоре 2009 года исследователи Microsoft уже описывали онлайн-эксперименты как инженерную и организационную систему, а не отдельный скрипт на странице. Microsoft Research, Online Experimentation at Microsoft.
Параллельно формировались большие маркетинговые наборы. После покупки Omniture в 2009 году Adobe получила аналитическую основу будущего маркетингового облака; инструменты тестирования и таргетинга постепенно стали частью более широкой среды Adobe. Само направление Omniture Test&Target предшествовало этой покупке. Получились две логики распространения: отдельный быстрый инструмент для команды, которая хочет запускать гипотезы, и комплексная корпоративная платформа, в которой эксперимент связан с контентом, данными и согласованиями. Adobe об истории сделки с Omniture и хронология компании.
Но облегчить публикацию оказалось проще, чем научить организацию правильно читать результат. Допустим, вариант “B” увеличил число нажатий на кнопку на 12%. Хорошо ли это для бизнеса? Возможно, люди чаще нажимают, потому что подпись стала понятнее. Возможно, обещание стало агрессивнее, но заявки чаще отсеиваются в отделе продаж. Когда тестов много, растёт вероятность случайно найти «победу», если просматривать десятки сегментов и метрик после получения данных. А если распределение трафика неожиданно стало 56/44 вместо ожидаемого 50/50, проблема может лежать в самом механизме назначения вариантов. Microsoft выделяет это как sample ratio mismatch — сигнал проверить эксперимент до интерпретации эффекта. Разбор Microsoft Research.
Разница между группами имеет смысл, когда посетителей распределили случайно, варианты действительно показали, а результат измерили одинаково. Поэтому вместе с редакторами развивались проверки качества эксперимента: ошибка в сборе данных способна сделать убедительным даже бесполезное изменение.
Здесь есть арифметика, которую редакторы страниц часто недооценивают. Предположим, исходная конверсия равна 2%, а желаемое улучшение — до 2,2%. Это рост на 10% относительно базы, но всего 0,2 процентного пункта в абсолютном выражении. При стандартных допущениях для двусторонней проверки, уровне значимости 5% и мощности 80% для различения таких долей потребуется приблизительно 80 тысяч посетителей на каждый вариант. Для выручки на посетителя или зависимых повторных наблюдений потребуется другой расчёт. Поэтому эксперимент с сотней комбинаций на небольшом сайте часто заканчивается убедительным дизайном отчёта, а не убедительным результатом. Microsoft Research о чувствительности метрик и MDE.
Даже накопив нужный объём, нельзя выбирать момент остановки только потому, что график наконец пересёк нужную отметку: частые незапланированные проверки повышают риск случайной «победы». Если одновременно изучать двадцать показателей и десятки сегментов, возникает проблема множественных сравнений. Методы коррекции по данным до эксперимента, например CUPED, могут уменьшить шум, но не превратят маленький невалидный тест в большой валидный. Для команды это означает вполне практическое ограничение: возможность быстро создать сто вариантов ещё не даёт трафика, необходимого для их проверки. Разбор постселекционного смещения в экспериментах и объяснение CUPED в документации Sales Ninja.
#Почему A/B-тест проще продать, чем персонализацию
История VWO позволяет увидеть разницу между возможностью программы и понятной причиной её купить. У первых пользователей Wingify было слишком много функций, с которыми предстояло разобраться. У Visual Website Optimizer появился ясный порядок действий: выбрать элемент страницы, сделать второй вариант, распределить посещения и сравнить результат. Человек мог представить, какую работу закончит с помощью продукта.
После A/B-теста решение снова принимает команда. Она оставляет победителя, отклоняет изменение или признаёт, что данных пока недостаточно. Даже неудачная гипотеза может оправдать проверку: компания не переносит её на весь трафик. Покупатель получает способ ограничить риск решения, которое и так собирался принять.
В постоянной персонализации решение о показе передаётся системе. Теперь недостаточно однажды утвердить новый заголовок. Нужно определить допустимые варианты, условия их применения и основания для остановки. Ответственный за сайт должен понимать, что именно программа вправе менять. Это касается и обещаний клиенту, и цен, и порядка действий в интерфейсе. Подписка начинает требовать от компании правил работы, которых раньше могло вообще не быть.
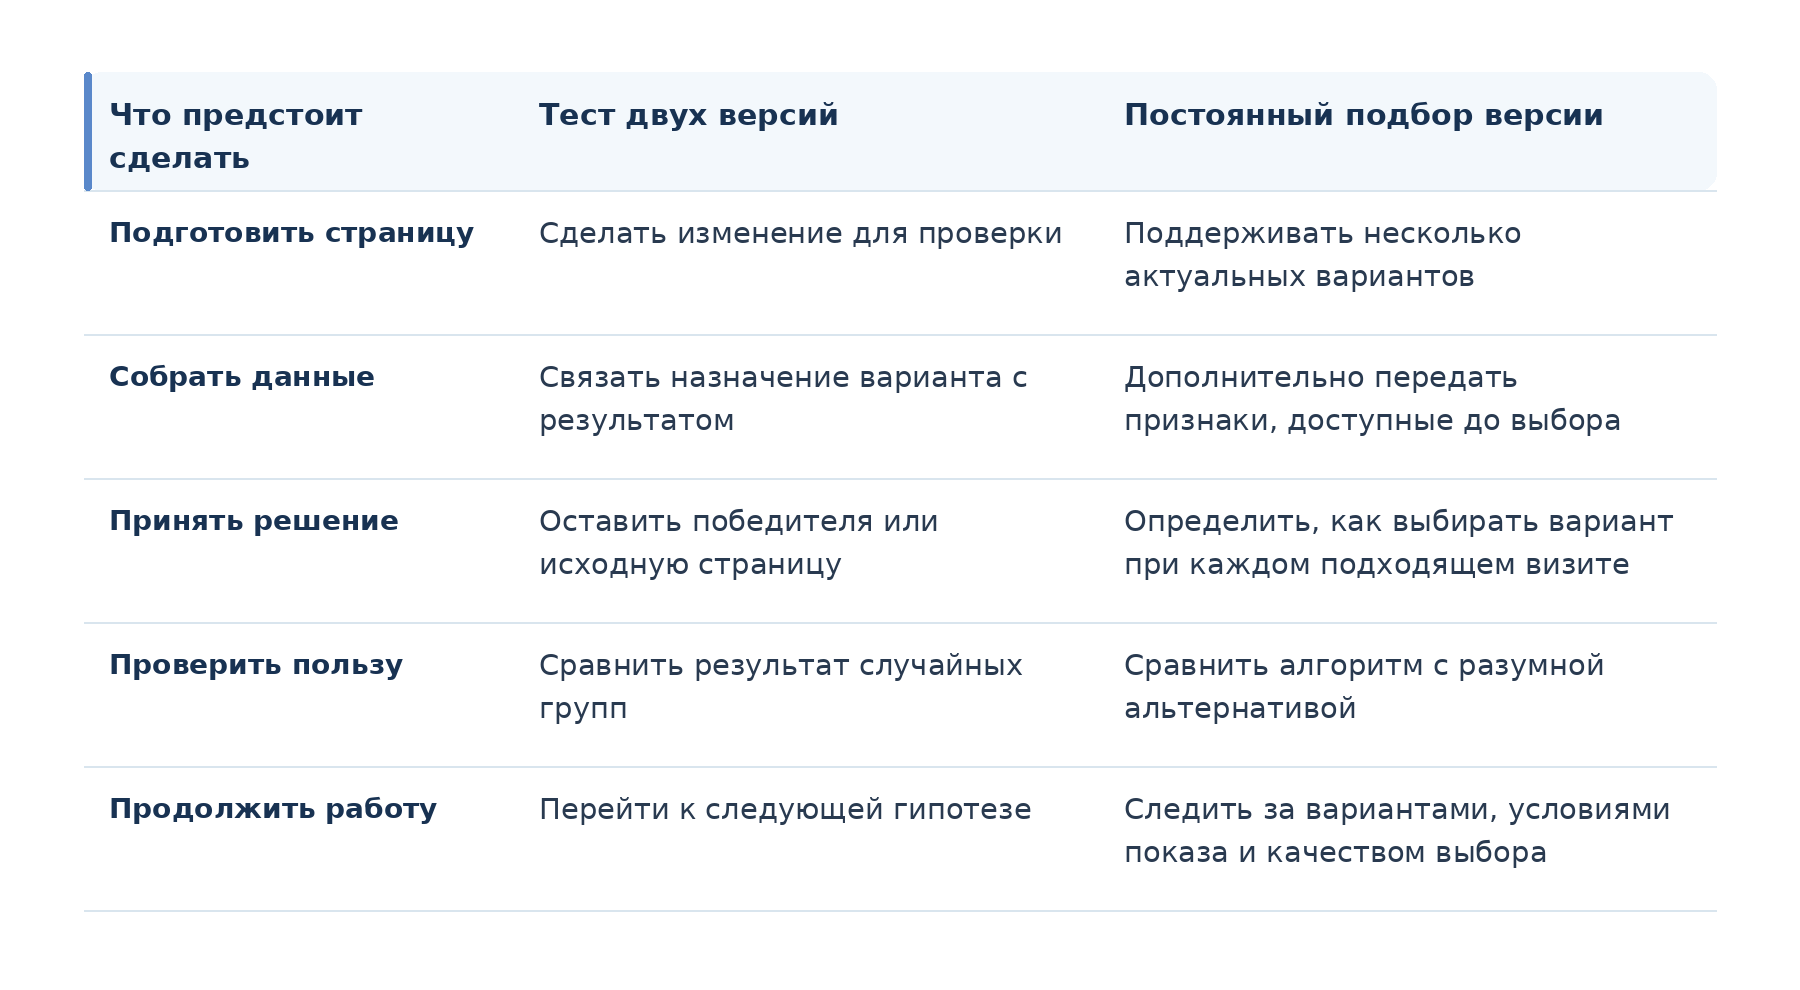
Такое устройство покупки помогает объяснить, почему A/B-тесты было проще предлагать в качестве первого продукта. Здесь понятны границы делегирования: программа проводит сравнение, человек решает, что делать дальше. Персонализация переносит часть следующих решений внутрь программы. Её ценность может быть выше, но до запуска труднее оценить объём подготовки и последующей работы. История VWO показывает, как ясная начальная задача облегчает покупателю выбор продукта.
Однако у этого объяснения есть сильный контрпример — рекомендации товаров. Магазину не нужно писать отдельную страницу для каждого покупателя: названия, фотографии и цены уже есть в каталоге. Алгоритм выбирает из готового ассортимента, а заказ позволяет быстро увидеть результат. Здесь персонализация может оказаться вполне понятной первой покупкой. Чем ближе предложение к конкретной работе — подобрать дополнение к товару, улучшить поиск, помочь выбрать фильм, — тем меньше клиенту приходится самостоятельно достраивать продукт.
Для рекомендаций легче ограничить и полномочия алгоритма. Он выбирает из утверждённого каталога и обычно меняет содержимое отведённого блока. Произвольное изменение страницы затрагивает гораздо больше: формулировки, обещания, формы, переходы. Чем шире область решения, тем больше поставщику приходится объяснять, как клиент сохранит контроль над сайтом. Поэтому конкретный продукт персонализации может быть понятнее широкой платформы, даже если использует сложную модель.
Ограничить изменение и выбрать одну версию удобно. Но удобство управления ещё не означает, что одна версия даст наибольший результат. Это и открывает следующий этап истории.
#Проблема одного победителя
Для короткого расчёта возьмём две версии страницы, A и B, и две равные по размеру группы: новых и возвращающихся посетителей. Пусть доля посетителей, выполнивших целевое действие, распределяется следующим образом. Числа условные.
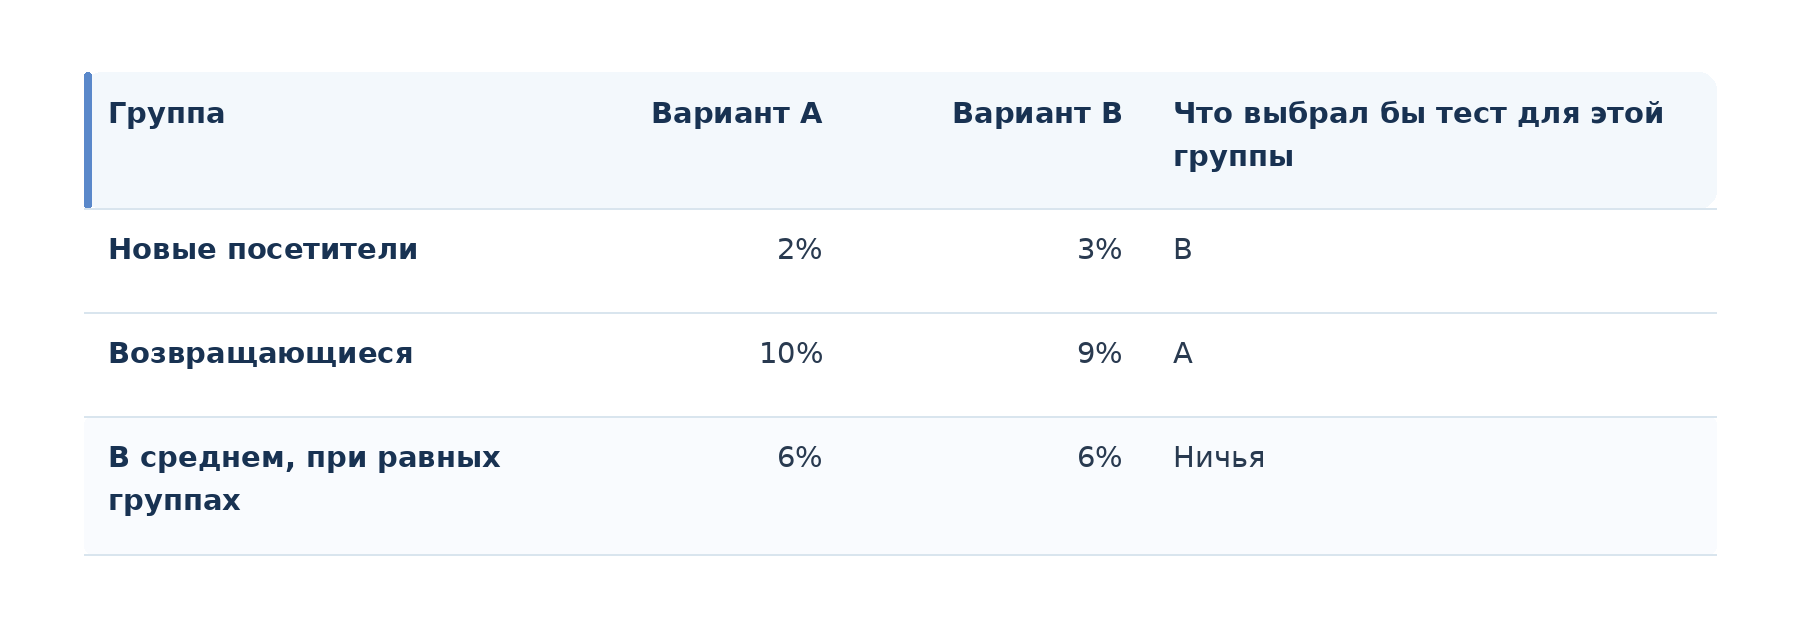
В сводном результате — ничья. При этом правило «новым — B, возвращающимся — A» дало бы 6,5%, или на 0,5 процентного пункта больше, чем единый вариант. Такой выигрыш сохранится, если различия устойчивы, а нового посетителя можно отличить от возвращающегося до выбора версии. На практике найденное правило надо проверить на новых данных: если разделить трафик после теста сотней способов, среди найденных сегментов неизбежно появятся случайные «победители».
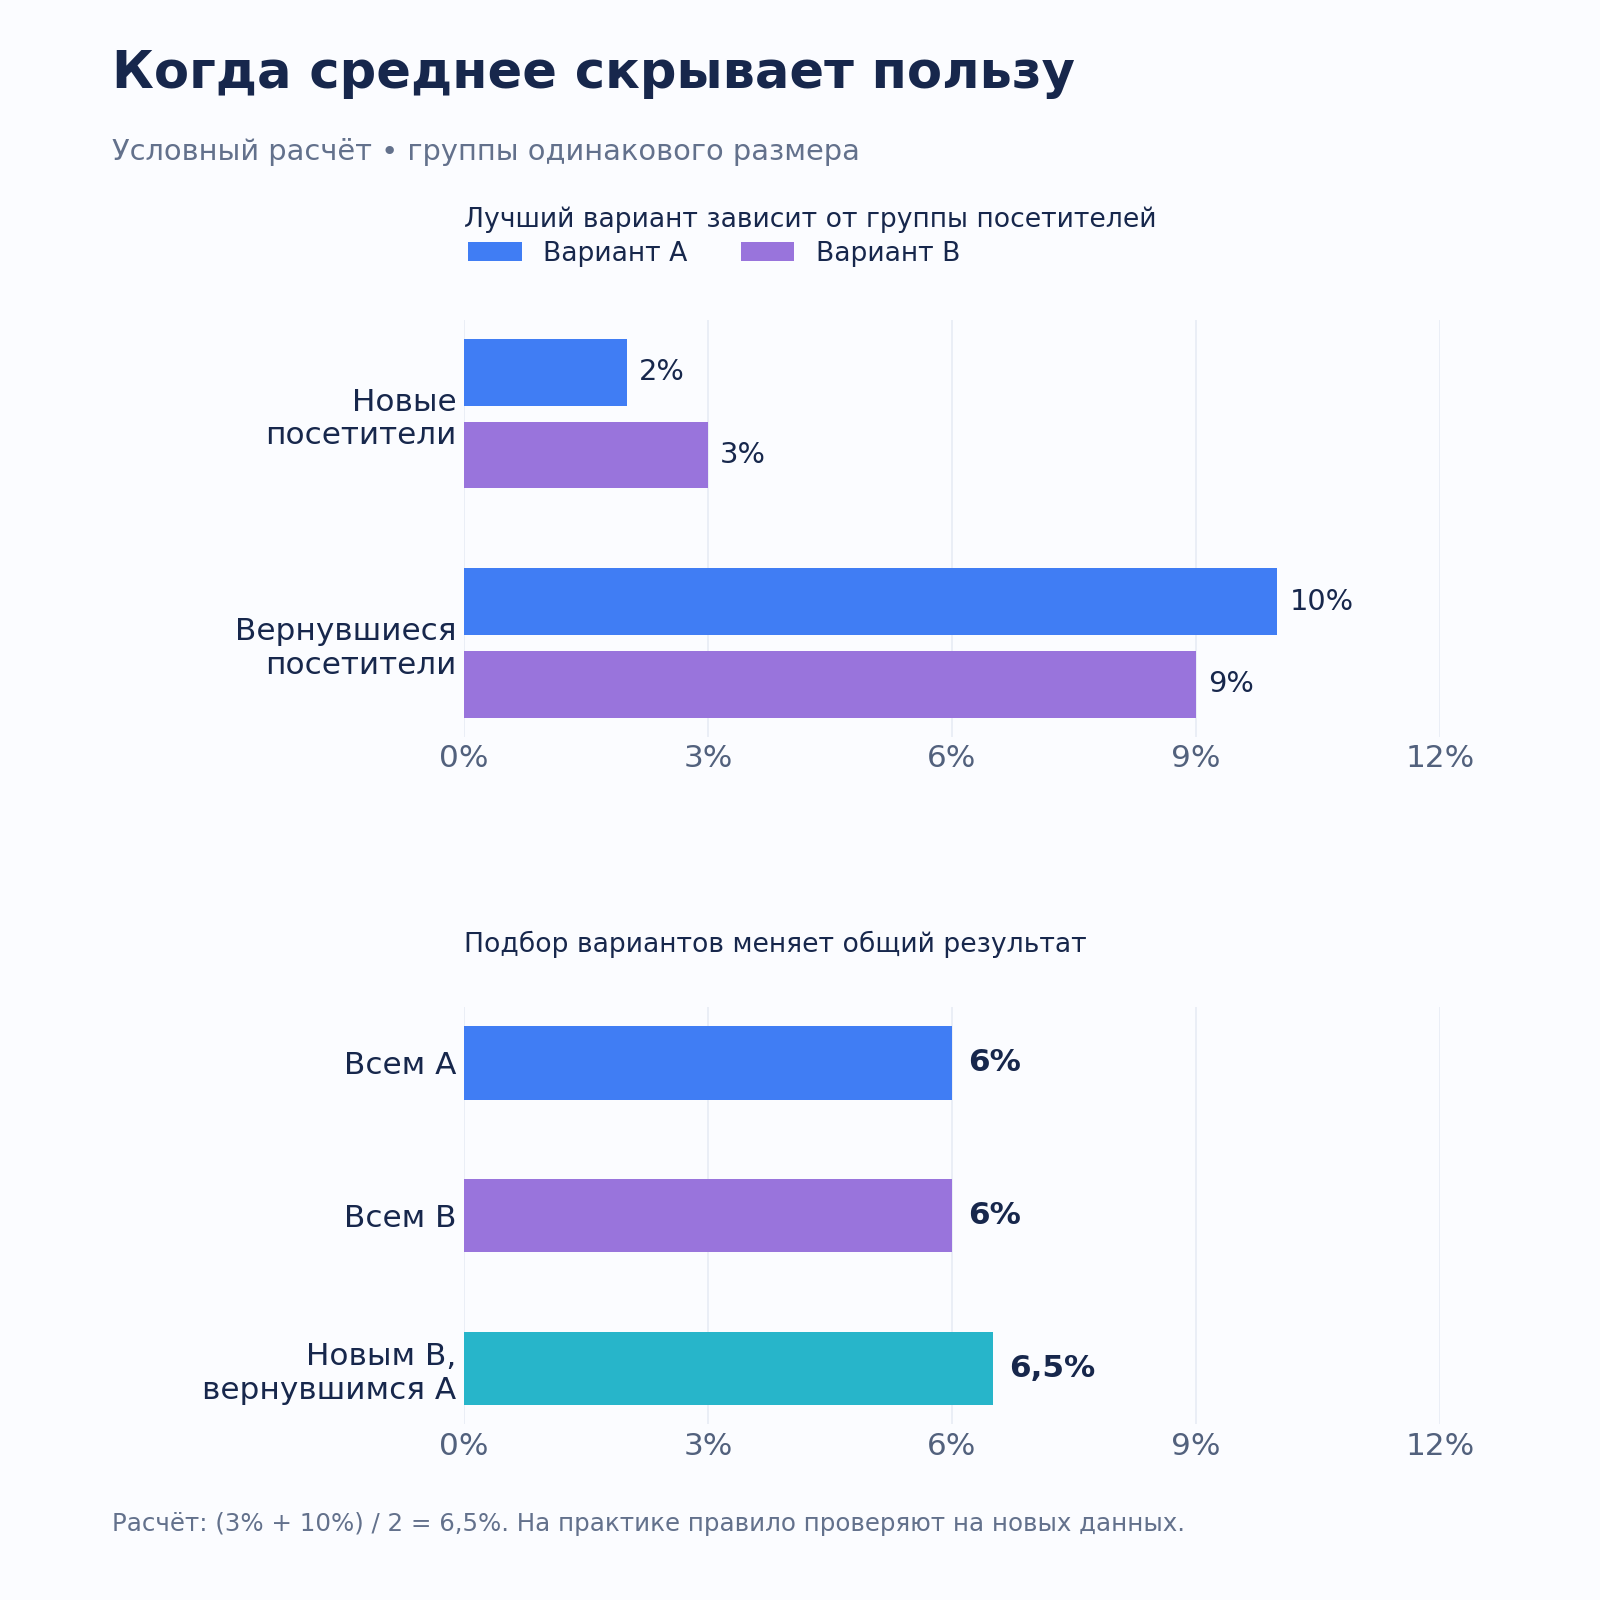
Такое наблюдение объясняет притягательность персонализации. Она пытается заменить поиск одной лучшей страницы выбором по обстоятельствам визита: какой вариант кому показывать. Контекст может включать страницу входа, источник визита, устройство, просмотренные товары, историю покупки и текущую корзину. Сама модель не обязана знать имя посетителя. Ей нужны признаки, связанные с решением, и обратная связь о результате.
Но здесь возникает другая проблема. Чем уже сегменты, тем меньше данных в каждом. Компания может уверенно знать среднюю конверсию страницы и почти ничего не знать о результате для узкого сочетания устройства, источника перехода, давности визита и времени суток. Число возможных правил растёт быстрее, чем объём данных для проверки каждого из них. Машинное обучение даёт возможность делить аудиторию гибче, но не отменяет малую выборку, смену поведения, неучтённые условия и стоимость ошибок.
#От правил к обучающейся странице
В первой массовой волне «персонализация сайта» часто означала набор условий. Если посетитель пришёл по рекламе определённой категории — покажите соответствующий баннер. Если в корзине есть товар — предложите дополнение. Если человек возвращается — уберите вводное объяснение. Такой подход способен приносить пользу: он прозрачен, удобен для юридических и брендовых ограничений, не требует большого объёма данных.
Но с ростом вариантов он начинает походить на таблицу исключений. У маркетолога появляются правила по каналам, устройствам, категориям, городам, давности визита; правила пересекаются, спорят за один блок и стареют. Платформы следующей волны — в том числе Evergage, Dynamic Yield, Monetate и Qubit — развивали сочетание поведенческих данных, рекомендаций, сценариев и экспериментов. Одни задачи по-прежнему решались явным правилом, другие передавались модели: автоматизация выбора развивалась поверх уже существующих способов менять страницу.
Adobe Target предложил использовать для персонализации варианты, уже подготовленные командой. В 2017 году компания описывала Auto-Target: варианты, созданные для A/B-теста, можно использовать для подбора версии страницы с помощью модели. Для клиента такой переход сохранял уже сделанную работу. Не надо сначала объяснять клиенту, зачем сочинять десять новых страниц до первого запуска модели. У него уже есть варианты, гипотеза и измерение; следующим вопросом становится «а одинаково ли они работают для всех?». Описание запуска Auto-Target и документация Adobe об Automated Personalization. При этом переход не устраняет ограничений по данным. Если одна версия выигрывает у другой только в редком сочетании обстоятельств, у модели может не хватить наблюдений, чтобы отличить закономерность от случайности. Автоматизация снимает часть ручной работы с сегментами, но уверенность в результате по-прежнему приходится зарабатывать экспериментом.
#Netflix: иногда персонализируют даже обложку одного фильма
Когда вариантов и материалов много, выбирать приходится сразу на нескольких уровнях. У Netflix одна из задач заключалась в том, чтобы собрать целую главную страницу. В техническом рассказе 2015 года Крис Альвино и Джастин Базилико объясняли, что мало ранжировать фильмы по вероятности просмотра. Надо ещё решить, какие ряды показать, сколько разнообразия оставить, где дать «Продолжить просмотр» и как не заставить человека искать недавно замеченный фильм в постоянно меняющейся витрине. Витрина, идеальная с точки зрения одной ML-метрики, может стать неудобной страницей. Исследование Netflix о персонализированной главной.
Следующим предметом выбора стала обложка одного и того же фильма. В разборе 2017 года Netflix объясняла идею на «Умнице Уилле Хантинге». Любителя романтического кино могла заинтересовать картинка с Мэттом Деймоном и Минни Драйвер, зрителя комедий — изображение Робина Уильямса. Это примеры возможных различий интереса, которыми авторы объясняли задачу; рабочая система искала закономерности в данных.
Содержание фильма не меняется, но зрителю показывают разные причины обратить на него внимание. У такой свободы есть неожиданная цена. Человек мог запомнить изображение, отложить просмотр и затем не узнать фильм под новой обложкой. Кроме того, выразительный крупный план способен выделиться среди соседних карточек, но страница из одних крупных планов потеряет разнообразие. Netflix рассматривала оба затруднения: лучший отдельный элемент не обязательно создаёт лучшую страницу.
Для выбора изображений компания использовала контекстных бандитов — алгоритмы, которые учитывают обстоятельства показа и продолжают исследовать варианты. Если всегда показывать только текущего фаворита, остальные изображения перестанут получать наблюдения. Если выбирать всё случайно, накопленные знания не принесут пользы. Приходится сочетать применение уже найденного решения с проверкой альтернатив.
Здесь появляется существенное отличие от теста с заранее выбранной датой окончания. У системы нет последнего посетителя, после которого навсегда известен ответ. Выходят новые фильмы, меняются интересы, у новых вариантов ещё нет истории. Обучение становится частью работающего интерфейса.
Похожую исследовательскую постановку для новостной витрины опубликовали Лихун Ли, Вэй Чу, Джон Лэнгфорд и Роберт Шапире в 2010 году. На данных Yahoo! Front Page размером более 33 млн событий их контекстный подход показал 12,5% прироста кликов относительно конкретного бандитного алгоритма без контекста. Для оценки была существенна ещё одна деталь: для честной офлайн-оценки новой политики нужны данные о том, с какой вероятностью прежняя политика показывала варианты. Оригинальная статья.
Сказать «алгоритм учится по кликам» недостаточно. Если алгоритм десять тысяч раз показал вариант A и лишь сто раз B, надо знать и условия этих показов. Само различие объёмов не создаёт смещения, но варианты могли доставаться систематически разным людям. Тогда сравнение их конверсий смешает качество варианта с особенностями аудитории. Иногда для оценки нужна рандомизация, иногда — методы коррекции вероятности показа, иногда — новый эксперимент. Система должна сохранять историю собственных решений. Иначе команда будет видеть, что показали и что купили, но потеряет возможность корректно сравнить способы выбора.
#Что считать удачным выбором
Даже при корректно собранных данных система может решать другую задачу, чем предполагает команда. Такой случай описали исследователи Amazon Prime Video. В 2014 году они проверяли нейросетевой автоэнкодер для рекомендаций. При первоначальной оценке его обгоняли и прежний алгоритм сходства товаров, и простой список популярных фильмов. Затем команда проверила более прикладной вопрос: окажется ли хотя бы один из шести рекомендованных фильмов среди последующих просмотров пользователя? При такой оценке результат модели оказался лучше. История исследования в Amazon Science.
Оценка должна соответствовать тому, что система делает в продукте. Если интерфейс отводит рекомендациям шесть мест, качество длинного списка может оказаться менее существенным, чем польза этих шести позиций. До сравнения моделей требуется определить, какое решение будет принято по итогам проверки. Иначе сложный алгоритм можно отклонить за слабость, которая почти не влияет на посетителя, или наградить за улучшение, которого посетитель не увидит.
#Высокий шанс купить — ещё не причина показывать предложение
Предположим, модель научилась хорошо предсказывать, кто купит. Возникает соблазн показывать выгодное предложение тем, у кого выше оценка. Однако прогноз покупки ещё не отвечает на вопрос, кому предложение поможет принять решение.
Рассмотрим отдельный условный пример: предложение продлить платную подписку со скидкой. У постоянных подписчиков вероятность продления составляет 80% без предложения и 81% с ним. У второй группы — 10% и 14%. Если выбирать адресатов по вероятности продления, первая группа выглядит привлекательнее. Но предложение добавляет ей лишь один процентный пункт, второй — четыре. К тому же скидку получат и люди, которые продлили бы подписку по полной цене. Для оценки прибыли нужно учитывать обе стороны: дополнительные продления и потерянную выручку с продлений, которые состоялись бы и так. Разницу между результатами с воздействием и без него называют uplift, или дополнительным эффектом.
Ни у одного человека нельзя одновременно наблюдать оба исхода одного и того же визита. Именно поэтому случайно назначенная контрольная группа так важна. Модель может оценивать неодинаковость эффекта по контексту, используя данные эксперимента, но её выводы остаются оценками. Исследования Сьюзен Атей и Стефана Вагера о causal forests формализовали один из подходов к оценке неоднородного эффекта; работа о моделях uplift в маркетинге прямо подчёркивает потребность в экспериментальных данных для обучения и проверки. Статья Атей и Вагера и исследование о цене сбора данных для uplift.
Есть и более тонкая ошибка: сегмент определяется после воздействия. Например, вариант страницы побудил человека дойти до корзины, а аналитик сравнивает результаты только «посетителей корзины». Группы уже изменены экспериментом. Для корректного сравнения важны признаки, доступные до выбора варианта, заранее оговорённая единица рандомизации и ясное понимание того, кого включили в анализ. Microsoft отдельно советует осторожно обращаться с динамическими сегментами и отслеживать, как эффект меняется по дням. Методические рекомендации Microsoft Research.
Отсюда следует требование к персонализации, которое легко потерять в демонстрации продукта. Высокая конверсия выбранной аудитории ещё не показывает, помогло ли ей изменение. Чтобы узнать добавочный эффект, нужны сопоставимые группы, различающиеся способом показа. Следующий вопрос — с какой именно альтернативой сравнивать алгоритм.
#За что именно алгоритм получает похвалу
В персонализации страниц нужно различать вклад двух изменений: одновременно меняются и материалы, и способ их выбора. Если новые материалы удачны сами по себе, общий прирост легко приписать алгоритму. Разделить эти эффекты позволяет устройство контрольной группы.
Выбор контроля определяет смысл результата. В Optimizely Personalization описана группа с исходной версией страницы. В Sales Ninja контроль получает случайный вариант из того же набора, которым пользуется модель.
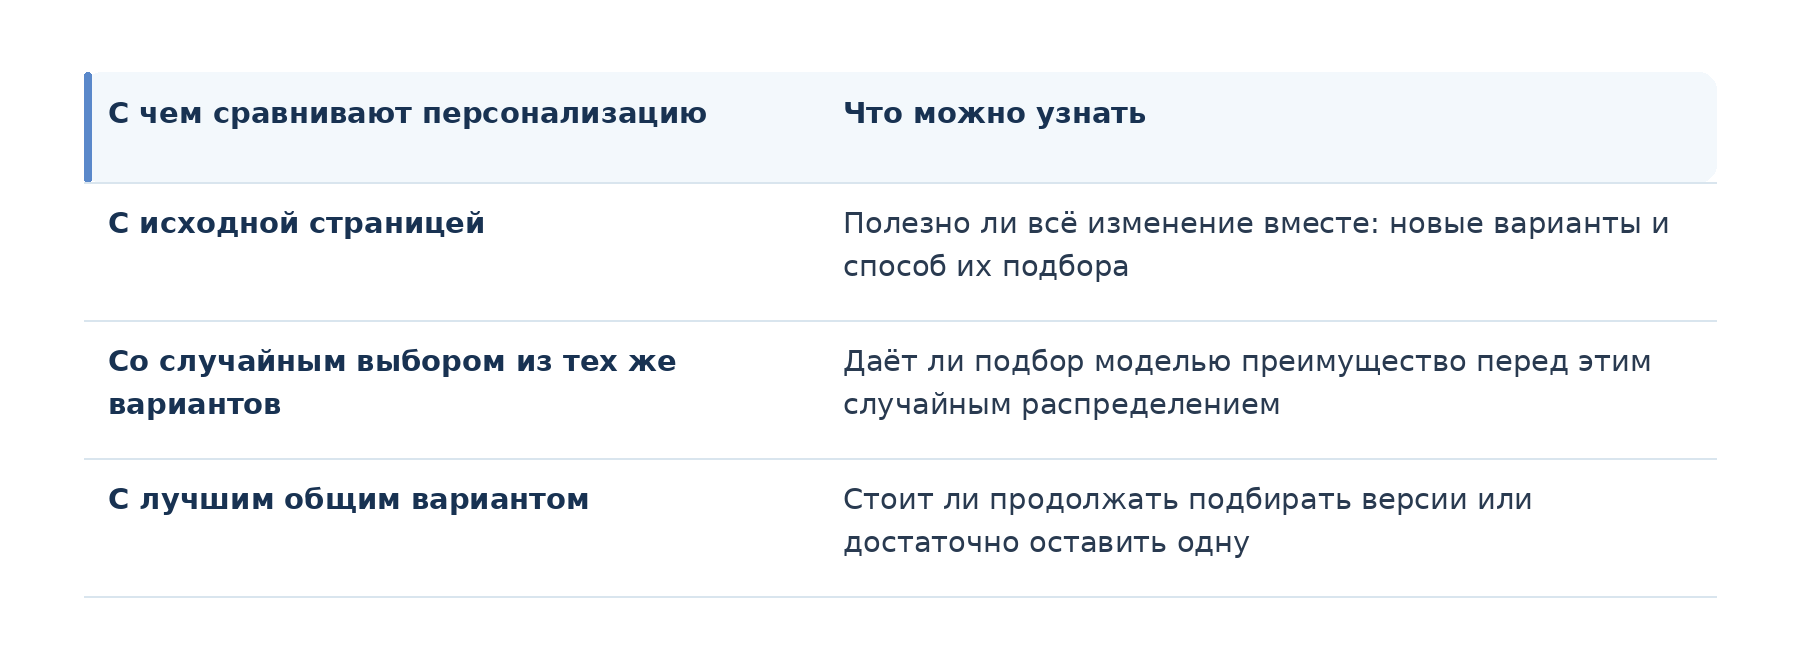
Допустим, новая версия A лучше B для любой аудитории. Модель может победить случайную раздачу, просто научившись чаще показывать A. Для этого ей вообще не требуется различать посетителей. Сравнение с показом A всем отвечает на более строгий вопрос: есть ли польза именно от подбора по контексту? Так A/B-тестирование возвращается внутрь персонализации уже как способ проверить сам алгоритм выбора. Проверяемым изменением становится целая система, а не отдельная кнопка.
#Почему вокруг персонализации собирались целые платформы
Проверенный алгоритм ещё нужно встроить в работу сайта. Ему нужны данные, набор допустимых вариантов и способ применить решение до того, как посетитель увидит страницу. Результат должен вернуться в систему, а устаревшие материалы — исчезнуть из показа. Между этими действиями проходят границы CMS, аналитики, CRM и ответственности разных команд. Поставщики персонализации начали расширяться в те области, без которых их собственная функция оставалась незавершённой.
Nosto вошла через каталог магазина. В собственной истории компания отсчитывает развитие с 2013 года и связывает замысел с помощью, которую покупатель получает от хорошего продавца. Рекомендациям уже есть из чего выбирать: магазин поддерживает ассортимент независимо от персонализации. Позднее Nosto добавила поиск, купив SearchNode и Findologic в 2022 году. Поиск и рекомендации встречают покупателя в разных обстоятельствах, но используют одни и те же сведения о товарах. История Nosto, покупка SearchNode, покупка Findologic.
У Dynamic Yield выбор вышел за пределы сайта. Основанную в 2012 году компанию в 2019-м приобрёл McDonald’s. Персонализация применялась, в частности, в цифровых меню drive-through. В 2022 году покупку Dynamic Yield у McDonald’s завершила Mastercard. Здесь место веб-страницы занимает экран заказа: программа выбирает, что предложить из доступного ассортимента в конкретных обстоятельствах. Mastercard об истории Dynamic Yield и закрытии сделки.
А для компании, которая хочет связать сайт с продажами после заявки, сначала возникает проблема данных. Человек оставил контакт в браузере, менеджер квалифицировал его в CRM, заказ оформили позднее. Пока эти события не связаны, алгоритм видит главным образом заявки и клики. Покупка Segment компанией Twilio в 2020 году объединяла коммуникационные инструменты с платформой клиентских данных. Такой слой помогает передать системам сведения о том, что случилось с посетителем за пределами конкретной страницы. Сообщение Twilio.
У других покупателей недоставало инструментов для выбора и изменения страницы. Salesforce приобрела Evergage в 2020 году, Coveo — Qubit в 2021-м. Первая сделка добавляла персонализацию в большую клиентскую платформу, вторая — усиливала предложение для электронной торговли рядом с поиском и рекомендациями. Episerver купила Optimizely в 2020 году, а в 2021-м приняла её имя: создание и публикация контента оказались рядом с экспериментами. Salesforce, Coveo, Optimizely.
Покупки компаний сами по себе не раскрывают экономику каждого продукта. Но состав объединяемых инструментов показывает, сколько работы окружает момент «модель выбрала вариант». Особенно хорошо это видно у Monetate. Персонализация Monetate и рекомендации Certona находились внутри Kibo; в 2022 году направление снова стало отдельной компанией Monetate. В 2025-м она купила уже знакомую нам SiteSpect, а летом 2026-го —** Simon AI**, платформу клиентских данных и управления коммуникациями. В одном предложении сошлись выбор контента, проверка результата, применение изменений и данные для следующего решения.Выделение из Kibo, SiteSpect, Simon AI.
У Webflow отправная точка была обратной: клиенты уже создавали сайты в её редакторе. Купив Intellimize в 2024 году, компания добавляла к созданию страниц инструменты их оптимизации и персонализации. Автор страницы получает возможность подготовить варианты там, где он привык работать, и затем проверить, какой результат они дают. Объявление Webflow.
Получается любопытное возвращение к истории VWO. Узкая функция помогала объяснить первую покупку, но по мере роста клиентов поставщикам приходилось соединять её с соседними задачами. В 2026 году VWO и AB Tasty объявили об объединении; по данным компаний, общий бизнес насчитывал более 4000 клиентов и свыше 100 млн долларов годовой повторяющейся выручки. Начальная простота и последующее расширение отвечают разным этапам работы покупателя. Объявление Wingify.
#Два поворота: Google закрывает продукт, Mutiny меняет работу клиента
У расширения есть цена. Нужно поддерживать интеграции, обслуживать сложные внедрения и развивать возможности, которые нужны опытным командам. Google Optimize и Optimize 360 прекратили работу 30 сентября 2023 года. Google объяснила решение тем, что продукту недоставало многих необходимых клиентам функций и сервисов, и перенесла внимание на интеграции Analytics с внешними поставщиками тестирования. Среди партнёров фигурировали Optimizely, VWO и AB Tasty. Официальная справка Google.
Инструмент, связанный с массовой аналитической платформой, уступил место специализированным сервисам. Команде, которая постоянно экспериментирует, нужны не только доступ к тесту, но и возможности для внедрения, анализа и сопровождения. Здесь завершился путь продукта Google, а работа по проверке изменений продолжилась у других поставщиков.
Mutiny обнаружила другую границу. Компания Джале Резаи предлагала B2B-маркетологам менять сайт под аудиторию без собственной команды разработчиков. Связать данные, показать нужное сообщение и проверить результат — привлекательное предложение для компании, у которой разные отрасли и клиенты требуют разных аргументов. Раннее описание Mutiny.
Но кто напишет эти аргументы? Маркетолог по-прежнему должен подготовить материалы и довести кампанию до запуска. В 2026 году Резаи объяснила перестройку Mutiny именно этим разрывом: слишком большую часть работы в прежней программе приходилось выполнять людям. По её словам, компания отказалась от прежнего SaaS-продукта, уже имевшего восьмизначную годовую повторяющуюся выручку, и перестроила предложение вокруг агента. Новый продукт создаёт материалы для работы с конкретными компаниями и сделками: страницы, предложения, презентации. Рассказ Резаи и описание перестройки в апреле 2026 года.
При таком повороте меняется обещание покупателю. Раньше ему давали удобный способ опубликовать и подобрать подготовленные материалы; теперь компания старается взять на себя больше работы по их созданию. Коммерческий итог новой стратегии ещё предстоит оценивать, однако сама причина поворота возвращает нас к началу: покупателю важен объём работы, который он сможет выполнить с приобретённым инструментом.
С похожей стороны к вопросу подошла Optimizely. В объявлении продукта персонализации 2024 года компания говорила о разрозненных данных и сложном процессе работы. В 2026-м она отдельно выделила нехватку подходящего контента и предложила агентные инструменты для его создания и сопровождения. Это объяснение поставщика, продающего соответствующее решение, но оно описывает узнаваемую практическую проблему. Объявление 2024 года, объявление 2026 года.
При этом быстрее написать текст и разрешить его публикацию — разные этапы. На странице финансового продукта формулировки должны соответствовать действующим условиям; в B2B-предложении нельзя подменять подтверждённые возможности продукта обещаниями, которые агент сочтёт убедительными. Генерация снижает стоимость подготовки черновика. Чем больше черновиков появляется, тем нужнее становится понятный порядок проверки: кто утверждает содержание, где оно может применяться и когда должно быть снято с показа.
Так становятся видны разные причины неудач. Первый Wingify было трудно понять. В Amazon неудачный критерий мешал оценить модель. Google отказалась от продукта, возможностей которого считала недостаточными. Mutiny пересмотрела, какую часть работы оставлять клиенту. У каждой истории своё препятствие; более точный алгоритм выбора помог бы далеко не во всех этих случаях.
#Как связать A/B-тесты и персонализацию в Sales Ninja
В наших обсуждениях Sales Ninja эта история проявилась с практической стороны: клиенту может быть интересна персонализация, но он не готов отдавать системе неограниченное право менять сайт. Возражение разумное. За опубликованное обещание отвечает компания, а не модель. Продукт должен позволять отделить утверждение допустимых изменений от выбора между ними.
В Sales Ninja A/B-тест, персонализация и действие по правилу используют общий способ описать изменения страницы. Различается способ показа: случайное распределение для сравнения, выбор модели или условие, заданное командой. Благодаря этому можно сохранить уже подготовленные варианты и менять способ работы с ними по мере появления данных.
A/B-тест здесь имеет самостоятельную ценность. Компания получает ответ на конкретную гипотезу и может закончить работу, оставив удачную версию. Если один вариант устойчиво лучше для всей аудитории, постоянный подбор остальных лишь добавит обслуживание. Персонализация оправданна, когда есть причина сохранять разные варианты: они помогают в разных обстоятельствах, а эти обстоятельства доступны системе до показа.
Sales Ninja позволяет перевести A/B-тест в персонализацию. Это продолжение уже выполненной работы: варианты существуют, цель определена, механизм применения проверен. Следующий шаг — выяснить, сможет ли модель использовать различия аудитории лучше общего решения или простого правила. Для перехода важна содержательная гипотеза о различиях, а не сам факт окончания теста.
Постоянная контрольная группа, описанная на странице персонализации Sales Ninja, получает случайный вариант из того же набора. Она позволяет оценивать преимущество модели перед этим распределением. Сравнение с лучшим единым вариантом отвечает на отдельный вопрос — окупается ли сама необходимость подбирать разные версии. Эти основания сравнения полезно различать уже при обсуждении пилота: от них зависит, какой результат команда сочтёт достаточным.
Для длинной воронки предусмотрена оптимизация по моделируемой конверсии. Такой ранний прогноз помогает получать сигнал до завершения сделки. Но качество сигнала нужно проверять по фактическим результатам: модель, которая быстрее учится на заявках, принесёт пользу лишь в той мере, в какой они связаны с нужными продажами.
Подготовкой гипотез и изменений занимается и Kohai, AI-агент Sales Ninja в альфа-версии. Эта часть продукта относится к ограничению, которое обнаружила Mutiny: автоматизированный выбор мало помогает, когда варианты некому подготовить. Работа с черновиками и подтверждением действий сохраняет за человеком решение о публикации; полезность опубликованных изменений проверяется дальше.
У товарных рекомендаций исходный материал уже находится в каталоге, поэтому их можно внедрять как отдельную ограниченную задачу. А API персонализации позволяет получать решение там, где браузерный способ изменения страницы не подходит. В обоих случаях остаётся общий принцип: определить область выбора, применить решение и связать его с наблюдаемым результатом.
Для такого продукта A/B-тестирование служит и понятной первой задачей, и постоянным способом проверки. Персонализация расширяет область решений, доступных команде. Её ценность становится убедительнее, когда понятно, какую дополнительную работу она выполняет после обычного теста и как эту пользу измеряют.
#После победителя
В кампании 2007 года команда искала страницу, которую можно оставить всем. Само решение было конечным. В персонализированной системе выбора после такого финала начинается новая работа: варианты остаются, аудитория меняется, программа продолжает выбирать.
Это и объясняет, почему простой эксперимент оказался удобным способом начать. Он помогал принять ограниченное решение и оставлял окончательное слово человеку. Для персонализации требовалось договориться о постоянных полномочиях системы, обеспечить её материалами и данными, а затем проверить, оправдана ли дополнительная сложность. Рекомендации находили более короткий путь благодаря готовому каталогу; платформы персонализации страниц пытались собрать недостающие части; агентные продукты теперь берутся за подготовку самих изменений.
A/B-тесты от этого не становятся устаревшей ступенью. Когда вместо страницы проверяют рекомендательную модель или способ подбора обложек, эксперимент поднимается на другой уровень. Он помогает решить, заслуживает ли новая система права обслуживать весь трафик. Персонализация получает пространство для постоянного выбора, а эксперимент сохраняет за командой возможность проверить, стоило ли этот выбор делегировать.