В каталоге сто тысяч товаров. В рекламе снова продаются одни и те же несколько сотен. На сайте посетители ходят по знакомым категориям, а большая часть ассортимента остаётся за пределами их внимания.
Кажется, что магазин сидит на нераскрытом сокровище: надо лишь начать показывать остальные товары — и выручка вырастет. Иногда так и происходит. Но иногда расширение продвижения приносит больше кликов, больше заказов и меньше денег.
Длинный хвост — это множество товаров, каждый из которых продаётся редко. Вместе они могут давать заметный оборот. Однако между «у этого товара есть покупатель» и «магазину выгодно найти этого покупателя» лежат стоимость рекламы, маржа, логистика и ещё одна неочевидная статья расходов: цена выяснения, кому вообще нужен этот товар.
Разберём, где в длинном хвосте находятся деньги, почему статистика часто их прячет и как связать рекламу, товарные рекомендации и прогноз конверсии, чтобы ассортимент работал на прибыль.
#Что на самом деле обещала идея длинного хвоста
В 2004 году Крис Андерсон описал в Wired экономику длинного хвоста на примере музыки, книг и фильмов. Обычный магазин ограничен полками: ему приходится выбирать то, что продаётся достаточно часто. Интернет позволяет держать гораздо более широкий ассортимент и соединять небольшие группы покупателей с редкими предложениями.
В этом есть сильная мысль: суммарный спрос на множество нишевых товаров может быть большим, хотя ни один из них не выглядит хитом. Ошибка начинается, когда из неё делают другое обещание: достаточно увеличить каталог, и дополнительная прибыль появится сама.
Ещё в 2003 году Эрик Бриньолфссон, Ю Ху и Майкл Смит исследовали ценность широкого выбора в онлайн-книжных магазинах. Они показали существенный выигрыш для покупателей от доступности большего числа книг. Именно для покупателей: возможность найти нужное издание имеет ценность даже тогда, когда продавец зарабатывает на нём немного.
У физического товара остаются закупка, хранение, доставка и риск устаревания. Даже если магазин работает со склада поставщика, нужно поддерживать остатки, цены, совместимость, описания и сроки поставки. Добавить строку в фид недорого. Обеспечить по этой строке хороший покупательский опыт — уже другая задача.
Поэтому длинный хвост полезно рассматривать как набор возможностей с разной экономикой. Одни товары заслуживают рекламного бюджета, другие — места в рекомендациях, третьи — спокойного присутствия в поиске по каталогу. Для некоторых само хранение запаса обходится дороже, чем доход от продаж.
#Каталог может расти быстрее, чем спрос
Если расположить товары от самых продаваемых к самым редким, получится знакомая кривая: несколько высоких значений в начале и длинная пологая часть справа. Но её форма ничего не говорит о том, сколько магазин заработает на добавлении следующей тысячи позиций.
В простых математических моделях спрос на товар с номером r иногда записывают так:
q(r) = a / r^α
Здесь q — число продаж за период, a задаёт масштаб, а α показывает, насколько быстро продажи уменьшаются по мере движения в хвост. Это условная модель распределения, а не универсальный закон торговли.
При α = 1 десятикратное расширение каталога даёт в приближённой непрерывной модели одну и ту же добавку продаж: a × ln(10). Увеличение с тысячи до десяти тысяч позиций и с десяти тысяч до ста тысяч требует совершенно разного объёма работы, а добавка по этой формуле одинакова. При α > 1 новые участки хвоста дают всё меньше продаж.
Есть и более простое ограничение. Если за месяц в магазин пришло сто тысяч человек, добавление ещё пятидесяти тысяч карточек не создаёт новых посетителей. Оно может помочь существующим людям найти более подходящее предложение, увеличить корзину или привлечь новый спрос из поиска. Но каждый такой эффект нужно получить отдельно.
Особенно легко перепутать ширину каталога и ширину спроса там, где много почти одинаковых вариантов. Десять новых цветов одного аксессуара могут распределить прежние продажи между десятью артикулами. Каталог вырос, число проданных единиц почти не изменилось.
Для магазина важен прирост результата от следующего товара, а не само число строк в каталоге.
#Где проходит экономическая граница хвоста
Начнём с денег, которые остаются от одной продажи до привлечения покупателя:
M = цена − закупка − переменные расходы на продажу
В переменные расходы могут входить эквайринг, сборка, оплачиваемая магазином доставка, комиссия площадки и ожидаемые расходы на возвраты. Состав зависит от бизнеса. Для сравнения товаров важно считать его последовательно.
M — маржинальный доход от продажи. Он ещё должен оплатить рекламу, содержание ассортимента и постоянные расходы компании. Поэтому называть его бухгалтерской чистой прибылью было бы неточно.
Теперь посмотрим на товар за выбранный период:
Вклад товара = число продаж × M − расходы на продвижение − расходы на содержание позиции
Допустим, дополнительная позиция продаётся два раза в месяц и оставляет по 700 рублей до рекламы. Получаем 1 400 рублей. Если её продвижение стоит 900 рублей, а связанные с ней расходы на запас и обслуживание — ещё 600, вклад оказывается отрицательным: −100 рублей.
При этом товар нужен людям, и у него действительно есть продажи. Просто в выбранном способе работы с ним магазин тратит больше, чем получает.
Если таких позиций тысяча, суммарная выручка может выглядеть внушительно. Но умножение отрицательного вклада на большое число товаров не улучшает экономику. Именно здесь заканчивается выгодное расширение хвоста — при текущих ценах, способе привлечения и расходах. Изменение этих условий может сдвинуть границу.
Она не обязана проходить по одному месту в общем рейтинге продаж. Редкий товар с хорошей экономикой может быть полезнее ходового товара, на котором почти ничего не остаётся. Значит, простой список «оставим самые популярные» тоже не решает задачу.
#Почему высокая маржа ещё не делает товар выгодным для рекламы
Для платного трафика нужен ещё один множитель: вероятность покупки после перехода. В простом случае, когда покупка содержит один рассматриваемый товар, ожидаемый вклад одного клика можно записать так:
Ожидаемый вклад клика = p × M − цена клика
Здесь p — вероятность завершённой покупки для конкретного трафика, а M — средний маржинальный доход от такой покупки до рекламы. Для корзин из нескольких товаров считают ожидаемый доход всей корзины; для отмен и возвратов — соответствующие исходы и их расходы.
Возьмём условный расчёт для трёх товаров. Все получают по тысяче рекламных переходов по 22 рубля. Проценты маржи в таблице означают долю цены, остающуюся после закупки, до остальных переменных расходов.
| Показатель | Ходовой товар | Специализированный товар | Нишевая позиция |
|---|---|---|---|
| Цена | 10 000 ₽ | 8 000 ₽ | 5 000 ₽ |
| Маржа после закупки | 6% | 30% | 45% |
| Прочие переменные расходы на продажу | 150 ₽ | 400 ₽ | 350 ₽ |
| M: остаётся до рекламы | 450 ₽ | 2 000 ₽ | 1 900 ₽ |
| Вероятность покупки | 2,5% | 1,8% | 0,4% |
| Ожидаемые покупки на 1 000 переходов | 25 | 18 | 4 |
| Ожидаемая выручка | 250 000 ₽ | 144 000 ₽ | 20 000 ₽ |
| Расходы на рекламу | 22 000 ₽ | 22 000 ₽ | 22 000 ₽ |
| ДРР | 8,8% | 15,3% | 110% |
| Вклад после рекламы, до постоянных расходов | −10 750 ₽ | +14 000 ₽ | −14 400 ₽ |
Ходовой товар выигрывает по числу покупок и выглядит красиво в отчёте по ДРР. Но 450 рублей с продажи не хватает, чтобы оплатить его привлечение. Специализированный товар покупают реже, ДРР у него выше, а денег он оставляет больше.
Третий товар имеет самую высокую процентную маржу. Однако выбранный трафик почти не покупает его, и реклама убыточна. Сортировка по марже подняла бы его наверх; сортировка по ожидаемому заработку учитывает и маржу, и спрос.
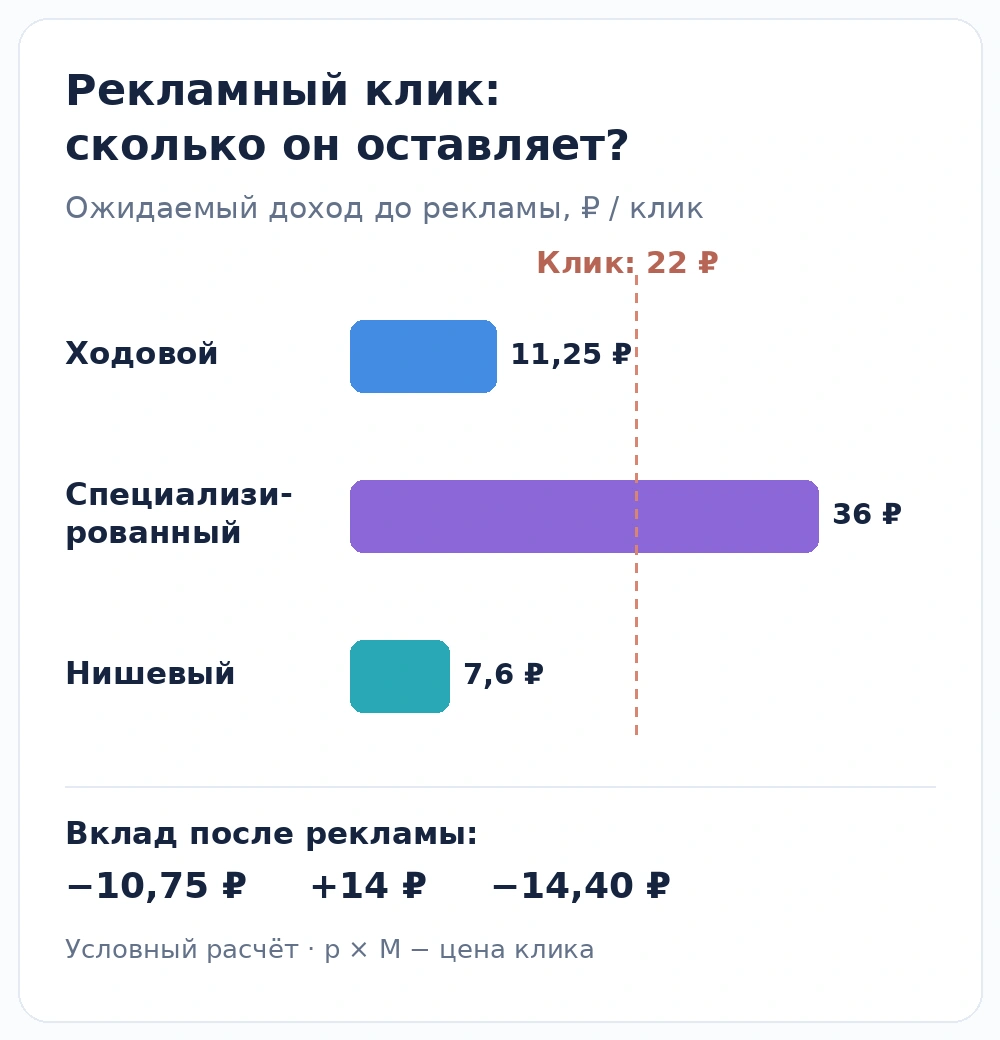
Для специализированного товара ожидаемый доход до рекламы равен 0,018 × 2 000 = 36 рублей на клик. При цене клика 22 рубля остаётся 14 рублей. Это и есть причина его преимущества, которую не видно в рейтинге самых продаваемых позиций.
Из той же формулы можно получить ориентир предельной цены клика:
Цена клика на границе окупаемости = p × M
Это граница до постоянных расходов и целевой прибыли. Рабочая ставка должна оставлять запас. Кроме того, по мере расширения охвата могут меняться и цена перехода, и вероятность покупки. Товар, выгодный на узкой аудитории, не обязательно останется таким при десятикратном увеличении бюджета.
#У одного товара может быть несколько разных экономик
До сих пор мы говорили о вероятности покупки как об одном числе. На практике она зависит от того, кому, где и в какой момент показали товар.
Редкий переходник для фотооборудования может быть почти бесполезен в широкой рекламной аудитории. Но человеку, который уже выбрал совместимую камеру и объектив, он нужен прямо сейчас. Товар тот же; задача покупателя другая.
Поэтому полезнее думать о вероятности p(покупка | товар, покупатель, контекст): шанс покупки при данных условиях. Важны открытая карточка, состав корзины, совместимость, регион доставки, предыдущие просмотры и стадия выбора.
В этом состоит одно из главных преимуществ рекомендаций для длинного хвоста. Они позволяют предложить редкую позицию внутри уже возникшего интереса, когда магазин знает о потребности больше, чем в момент первого рекламного показа.
Рассмотрим отдельный условный пример. Аксессуар оставляет 600 рублей после закупки и расходов на его добавление в заказ. При самостоятельном привлечении тысяча переходов по 22 рубля даёт десять покупок: 6 000 рублей маржинального дохода против 22 000 рублей рекламы. Получаем −16 000 рублей.
Теперь предложим его тысяче посетителей с подходящим основным товаром в корзине. Пусть аксессуар добавят 80 человек. Тогда он принесёт 48 000 рублей до стоимости работы рекомендаций и других дополнительных расходов. Отдельную рекламную закупку ради этих показов делать не понадобилось: посетителей уже привлекли для основной покупки.
Однако все 48 000 рублей нельзя автоматически записать в эффект рекомендательной системы. Допустим, без блока этот аксессуар купили бы 30 человек. Тогда прирост составляет 50 продаж, или 30 000 рублей. Стоимость исходного привлечения остаётся в экономике заказа; рекомендации меняют отдачу от уже полученного трафика.
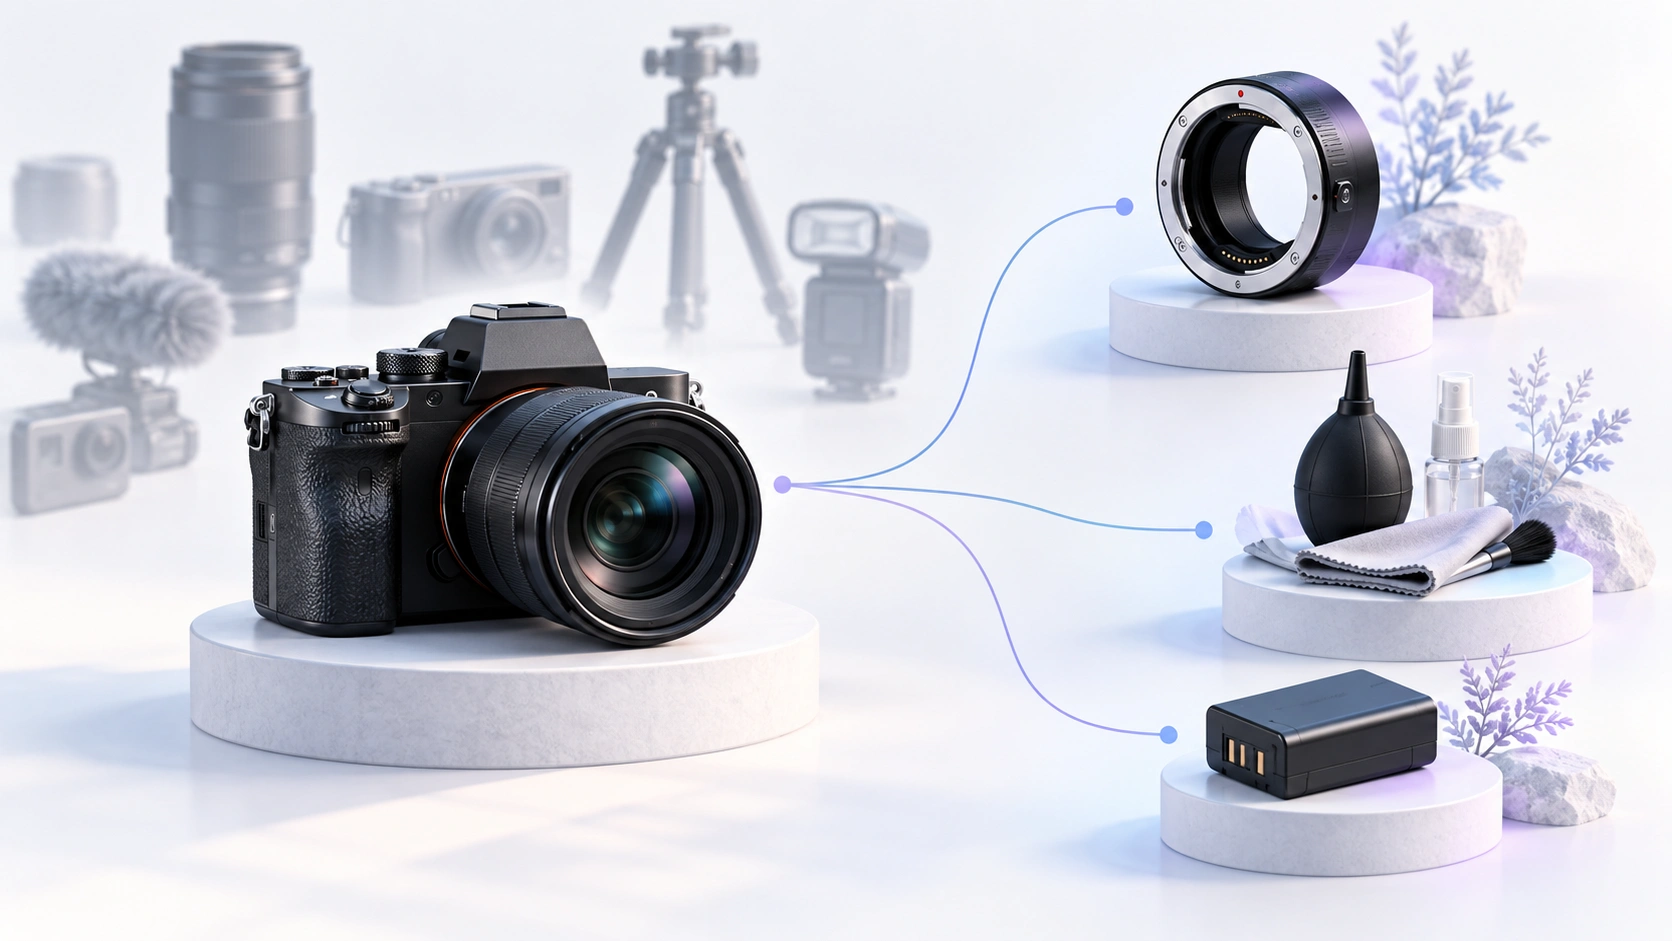
Получается, один товар может одновременно быть слабым кандидатом для широкой рекламы и сильным кандидатом для дополнения корзины. Общий вердикт «плохой товар» стирает это различие.
Так же меняется экономика по регионам и каналам. Доставка тяжёлой позиции в один город оставляет приемлемый доход, в другой съедает его. Товар с понятным техническим назначением находит покупателей по точному поисковому запросу, но плохо работает в ленте. Для повторной покупки расходника нужны другие условия, чем для первого знакомства с брендом.
Длинный хвост становится управляемым, когда у товаров появляются разные роли и способы продвижения.
#Почему «нет продаж» ещё не означает «нет спроса»
Самая неприятная часть работы с хвостом — недостаток наблюдений. Если товар продаётся редко, его легко выключить раньше, чем система успеет понять его потенциал.
Пусть настоящая вероятность покупки составляет 1%. После ста подходящих переходов вероятность не получить ни одной продажи равна:
P(0 покупок) = (1 − 0,01)^100 ≈ 36,6%
Даже у товара с нормальной конверсией более чем в трети таких проб будет ноль продаж. После 300 переходов вероятность нуля снизится примерно до 4,9%. Расчёт предполагает независимые переходы, постоянную вероятность и полностью наблюдаемый результат; задержки покупок и смена аудитории дополнительно усложняют оценку.
Но 300 переходов на каждый артикул — дорого. При цене 22 рубля это 6 600 рублей на одну позицию. На двадцать тысяч позиций — 132 миллиона рублей. И речь только о масштабе проверки, а не о сумме безвозвратного убытка: часть товаров принесёт продажи. При этом даже триста наблюдений не гарантируют точную оценку конверсии.
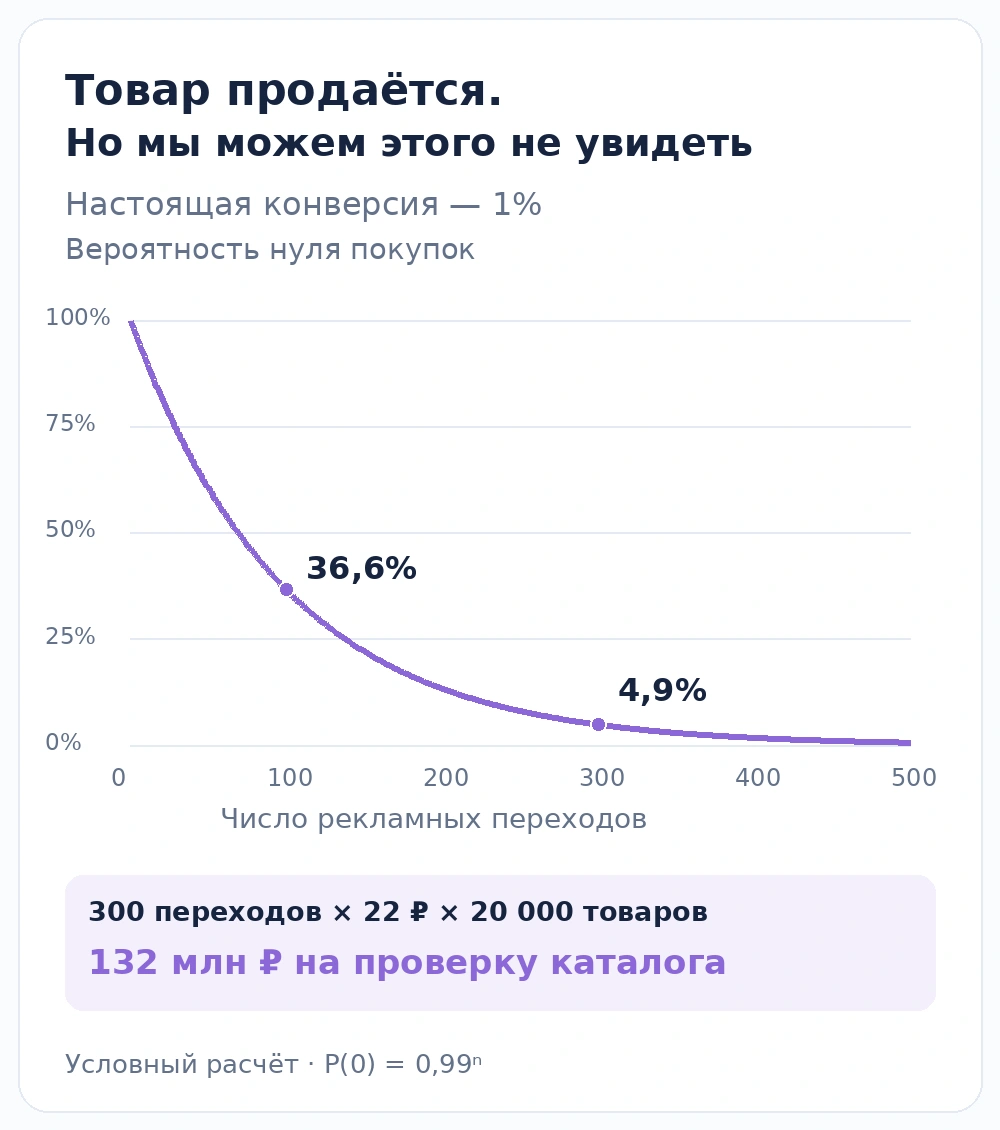
Так проявляется второй предел длинного хвоста: магазину может не хватать бюджета, чтобы надёжно изучить каждый товар по отдельности.
Возникают две противоположные ошибки. Если давать всем позициям немного трафика, бюджет расходуется, а убедительного ответа по большинству товаров всё равно нет. Если оставлять только доказанные хиты, новые и редкие товары почти никогда не получают шанса показать себя.
Для этого не требуется предполагать, что рекламная платформа равномерно делит бюджет между всеми артикулами. Даже неравномерный отбор сталкивается с той же проблемой: решения по малым выборкам нестабильны, а полноценная проверка всего ассортимента слишком дорога.
#Как находить перспективные товары, не проверяя каждый с нуля
Машинное обучение полезно здесь прежде всего тем, что позволяет использовать опыт похожих ситуаций.
Если у нового товара ещё нет покупок, уже могут быть известны его категория, характеристики, цена, совместимость и сходство с другими позициями. У посетителя тоже есть контекст: какие товары он смотрел, что сравнивал, что положил в корзину. Вместо двадцати тысяч полностью изолированных экспериментов можно оценивать общие закономерности и уточнять их по мере поступления результатов.
В рекомендательных системах для этого используют свойства товаров и историю взаимодействий. Первый подход помогает сопоставить потребность с характеристиками, второй — заметить связи, проявляющиеся в поведении покупателей. Их сочетание особенно полезно там, где одному артикулу не хватает собственной статистики.
Например, в каталоге есть совместимая деталь с хорошим маржинальным доходом. По общему числу покупок она далеко от лидеров. Но посетители, изучающие определённую группу оборудования, выбирают её заметно чаще. Для магазина это кандидат на точечное продвижение внутри этой потребности.
Неявность такой позиции состоит в том, что её ценность скрыта общим средним. Она редко продаётся всем посетителям, зато хорошо работает в подходящем сегменте. Чем больше ассортимент, тем сложнее найти такие сочетания вручную.
При этом совместные покупки ещё не доказывают, что рекомендация вызвала дополнительную продажу. Люди могли бы собрать тот же комплект самостоятельно. Модель помогает выбрать перспективное предложение; отдельная проверка показывает, принесло ли его размещение прирост.
Есть и риск, что рекомендации начнут усиливать уже популярных лидеров. Дэниел Фледер и Картик Хосанагар показали в исследовании 2009 года, что некоторые алгоритмы способны уменьшать разнообразие продаж: товары с большой историей получают ещё больше показов, а позиции с малой историей остаются незаметными. При этом отдельному человеку рекомендации могут открывать новое, но всем людям — примерно один и тот же набор.
Поэтому задача не сводится к установке любого блока «вам понравится». Важны доступный набор кандидатов, контекст, денежная цель и возможность ограниченно проверять новые предложения. Сплошное продвижение хвоста столь же неразумно, как его постоянное исключение.
#Где помогают смарт-фиды, а где — товарные рекомендации
Из разобранной экономики следуют две разные задачи. До визита нужно решить, какие товары стоит выводить в рекламу. После визита — что полезно предложить этому покупателю сейчас.
Смарт-фиды Sales Ninja работают с первой задачей: из исходного каталога формируются товарные выгрузки под разные рекламные сценарии. Один набор может использоваться в поиске Яндекс Директа, другой — в сетях или ретаргетинге. Это позволяет учитывать различия между способами привлечения, вместо того чтобы каждый раз отправлять весь ассортимент без разбора.
При работе с длинным хвостом полезно отдельно рассматривать товары с самостоятельным спросом, позиции для повторного обращения и дополнения к уже выбранным покупкам. Перспективный нишевый товар получает место в подходящем сценарии; слабая позиция не обязана постоянно расходовать бюджет широкой кампании.
По документации смарт-фидов, динамический отбор использует цели и товарный сигнал, а моделируемая конверсия может быть источником этого сигнала. Для фидов доступны метрики количества конверсий, выручки и прибыли. Таким образом, критерий отбора можно связать с тем, на чём магазин зарабатывает.
Важно сохранить различие между рекламной подборкой и полным каталогом. Если позиция сейчас не подходит для платного привлечения, она всё ещё может быть полезна на сайте. Более того, в Sales Ninja источником товарных рекомендаций служит исходный каталог, а не отфильтрованная рекламная подборка. Это позволяет не потерять ассортимент на следующем этапе.
Товарные рекомендации Sales Ninja решают вторую задачу. В карточке можно предложить дополнение или альтернативу, в корзине — подходящий добор, в каталоге — подборку с учётом интереса посетителя. Модель может оптимизироваться по конверсиям, выручке или прибыли; при этом данные о расходах должны поступать в проект.
Для длинного хвоста особенно ценен поиск сочетаний: подходящий посетитель, нужный момент, совместимый товар и достаточный заработок с покупки. Так можно подсветить высокомаржинальную позицию, которую общий рейтинг популярности оставлял далеко внизу. Высокая маржа здесь работает вместе с релевантностью: предложение должно помогать человеку завершить его задачу.
#Зачем этому механизму моделируемые конверсии
Даже после отбора товаров остаётся проблема редкого сигнала. Покупка специализированного оборудования может происходить после нескольких визитов. За неделю отдельный сегмент получает несколько завершённых заказов, и оценивать его только по этим событиям трудно.
Между первым переходом и заказом уже есть полезные наблюдения: человек сравнивал совместимые модели, возвращался к характеристикам, собирал комплект. По совокупности таких признаков можно оценивать вероятность конечного результата раньше, чем он произойдёт.
В простом объяснительном примере сто визитов с прогнозом покупки 1% дают ожидаемо одну покупку, а сто визитов с прогнозом 4% — четыре. При одинаковом маржинальном доходе 2 000 рублей ожидаемая денежная ценность групп составляет 2 000 и 8 000 рублей соответственно. Это ожидание для множества визитов; конкретный исход остаётся случайным.
Если вероятность и денежная ценность оцениваются достаточно хорошо, такой прогноз помогает различать трафик ещё до накопления большого числа завершённых заказов. При разной экономике покупок полезнее оценивать ожидаемый маржинальный доход, учитывая вероятность и возможный результат заказа.
Моделируемые конверсии Sales Ninja формируют более ранний и плотный сигнал для оптимизации. Цель и ценность настраиваются под задачу проекта; прогнозы передаются в рекламные системы через подключённые интеграции. Модель может учитывать различия между кампаниями и крупными сегментами трафика, что важно для неоднородного ассортимента.
Тот же тип прогноза можно использовать при динамическом отборе фидов и как дополнительный сигнал товарных рекомендаций. Получается согласованная работа на трёх этапах: выбрать ассортимент для привлечения, помочь человеку найти подходящее предложение и передать рекламе оценку перспективности визита.
У этого подхода есть вполне конкретная граница. Моделируемые события — прогнозы, связанные с исходными наблюдениями, поэтому их нельзя считать новыми независимыми покупками при оценке статистической уверенности. Реальные продажи, выкупы и возвраты нужны для обучения и проверки. Калибровка должна удерживать прогнозируемую ценность в соответствии с наблюдаемыми результатами, а настройки — предотвращать двойной учёт одной и той же ценности.
Формулы выше объясняют экономический смысл такого сигнала; они не описывают внутренний алгоритм Sales Ninja. Практический результат зависит от того, насколько хорошо данные позволяют отличать перспективные визиты и прибыльные покупки.
#Как понять, что длинный хвост действительно стал приносить больше
Рост числа проданных артикулов радует, но сам по себе ещё мало что говорит. Можно продать больше редких товаров, одновременно снизив прибыль всей корзины или вытеснив более выгодные покупки.
Проверку стоит строить вокруг общего денежного результата. Для рекомендаций полезно сравнивать маржинальный доход на всех посетителей, которым блок мог быть показан, в тестовой и контрольной группах. Тогда в расчёт попадут и допродажи, и замены, и возможное влияние блока на завершение основного заказа.
Для рекламных фидов важен вклад после рекламных расходов при сопоставимых условиях. Если бюджет просто переехал с популярных товаров на нишевые, нужно проверить итог всего затронутого ассортимента. Оценка только новых победителей оставит за кадром то, что магазин потерял в другом месте.
В рабочем отчёте стоит держать рядом несколько показателей:
- Маржинальный доход после рекламы — чтобы рост выручки не скрывал ухудшение экономики.
- Доход на посетителя или заказ — чтобы видеть эффект рекомендаций на всей покупке.
- Выкуп, отмены и возвраты — чтобы ранний успех не оказался поздним убытком.
- Доля и вклад новых позиций — чтобы понимать, находит ли система перспективные товары за пределами прежних лидеров.
- Стоимость проверки новых предложений — чтобы поиск будущих победителей оставался управляемым.
Для редких продаж особенно важна длительность наблюдения. Если товар покупают после нескольких возвращений, недельный тест может закончиться раньше, чем проявится результат. И если оценки прибыли имеют широкий диапазон неопределённости, небольшое преимущество ещё не даёт основания объявить победителя.
Начинать удобнее с части каталога, где достоверны остатки, состав заказов и данные о расходах. Дальше расширять подход по мере того, как подтверждается его польза. Так магазин получает понятный ответ: какие решения действительно добавляют деньги, а какие лишь меняют распределение продаж.
#Богатство магазина — в найденных сочетаниях
Большой каталог создаёт возможность встретить больше разных потребностей. Чтобы эта возможность стала прибылью, нужно найти подходящее сочетание товара, покупателя, момента и стоимости продажи.
Часть длинного хвоста стоит привлекать через точный спрос. Часть выгоднее раскрывать внутри уже собранной корзины. Некоторые позиции нужны для полноты выбора, хотя постоянное рекламное продвижение им не подходит. И даже хороший товар может перестать окупаться, если ради расширения охвата магазин покупает слишком дорогой или неподходящий трафик.
Смарт-фиды, товарные рекомендации и моделируемые конверсии помогают решать эти задачи вместе: выбирать ассортимент для рекламного сценария, показывать уместное предложение на сайте и раньше оценивать ценность визита. Проверять такую работу нужно по дополнительным деньгам от реальных покупок.
У длинного хвоста нет обязательства сделать магазин богатым. Его ценность появляется там, где магазин умеет находить спрос дешевле, чем зарабатывает на его удовлетворении.
#Источники и материалы
- Chris Anderson. The Long Tail, Wired, 2004 — исходное объяснение экономики нишевого спроса.
- Brynjolfsson, Hu, Smith. Consumer Surplus in the Digital Economy, 2003 — исследование ценности расширения выбора для потребителей.
- Fleder, Hosanagar. Blockbuster Culture’s Next Rise or Fall, 2009 — влияние устройства рекомендаций на разнообразие продаж.
- Google for Developers: типы рекомендательных систем — свойства товаров и взаимодействия пользователей как основа подбора.
- Sales Ninja: смарт-фиды, товарные рекомендации, моделируемые конверсии.
- Документация Sales Ninja: динамическая обработка фидов, метрики фидов, цели и обучение рекомендаций, моделируемые конверсии.
Все численные примеры и графики в статье — условные расчёты для объяснения механизма. Возможности продукта проверены по публичным страницам и документации 7 октября 2026 года.