Полный перевод статьи «Reach for the Top: How Spotify Built Shortcuts in Just Six Months». Оригинал: Spotify Engineering, 15 апреля 2020 года. О работе команды рассказывает руководитель инженерной команды Damien Tardieu. Далее «мы» — команда Spotify. Примечание Sales Ninja вынесено в конец и не входит в оригинал.
Запуск Shortcuts, блока, который теперь находится в верхней части главной страницы Spotify, — важный шаг вперёд в том, как слушатели взаимодействуют со своей любимой музыкой и подкастами. Руководитель инженерной команды Damien Tardieu рассказывает историю запуска этой новой интересной функции и объясняет, почему методология, выбранная для её разработки, стала основой успеха.
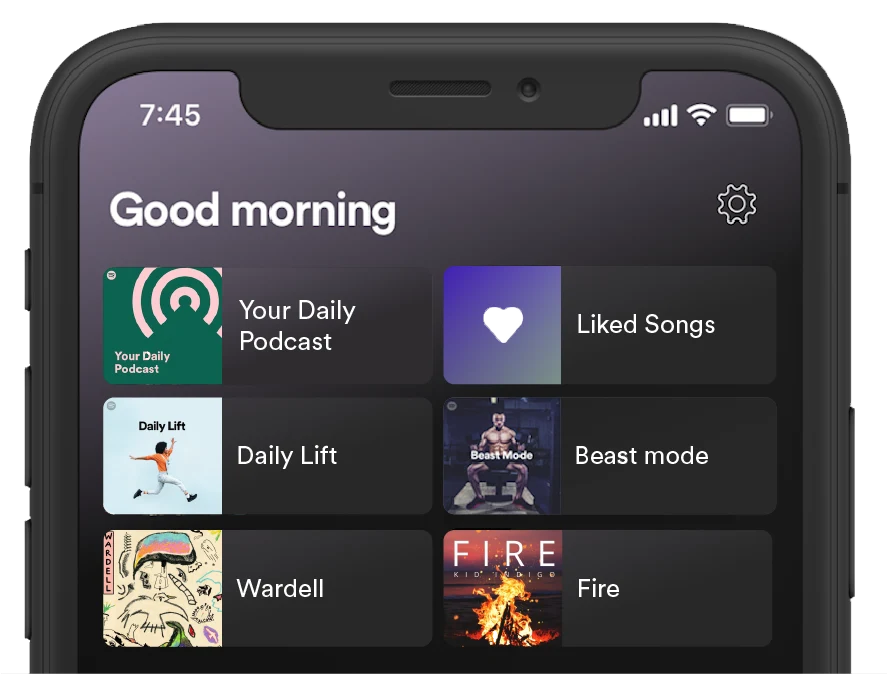
Качество нашего персонализированного контента — то, что отличает Spotify от остальных участников рынка музыкального стриминга. Такие плейлисты, как Discover Weekly, и рекомендации новых подкастов побуждают слушателей пробовать оригинальный контент и открывать незнакомых исполнителей. Но персонализация также должна обеспечивать быстрый доступ к любимому контенту, к которому вы постоянно возвращаетесь. Найти правильный баланс между знакомым и новым — одна из самых сложных задач, с которыми мы сталкиваемся при работе над пользовательским опытом.
Именно поэтому Spotify постоянно ищет способы улучшить главную страницу. В начале прошлого месяца мы запустили Shortcuts: новый способ для слушателей вернуться к музыке и подкастам, которые они недавно включали или часто слушают. Как вы, вероятно, уже заметили, это область в верхней части экрана с шестью карточками — или, как мы их называем, «объектами» (entities), — отражающими ваши недавние привычки прослушивания.
В течение нескольких месяцев до запуска над созданием Shortcuts совместно работали многие команды. Мы разработали и протестировали визуально новый пользовательский опыт (UX), на который пользователи могли бы положиться на главной странице Spotify. Мы дополнили его персонализированными рекомендациями, основанными на том, что пользователь с наибольшей вероятностью включит следующим. В оставшейся части статьи я сосредоточусь на том, как мы выявили и количественно оценили возможности, которые мог открыть Shortcuts, а затем разработали эвристики и модели рекомендаций. Я также объясню, как был устроен наш процесс, как мы последовательно дорабатывали эвристики — а в итоге и модели — и как проводили офлайн- и онлайн-оценку, чтобы надёжно рекомендовать знакомый и персонализированный контент.
#Понимание пользовательского опыта
Прежде чем разрабатывать новую функцию, крайне важно понять, будет ли она полезна и насколько. Поскольку основная цель Shortcuts — рекомендовать то, что сейчас находится у пользователя в числе любимого, первым делом мы измерили, в какой степени пользователи слушают знакомый контент по сравнению с новым.
Наш анализ показал, что в течение недели значительная доля прослушиваний конкретного пользователя в Spotify приходится на относительно небольшое число объектов. Объектом может быть определённый пользовательский плейлист, альбом или подкаст. Это также может быть плейлист Spotify — например, Rap Caviar, Discover Weekly или Release Radar. В этом нет ничего особенно удивительного. Какими бы разнообразными ни были наши музыкальные вкусы, обнаружив новую песню или альбом, которые нам действительно нравятся, большинство из нас склонны слушать их снова и снова. Это отличается от других медиа, например телевидения, где нам часто достаточно посмотреть что-либо один раз. У нас также есть привычные способы знакомиться с новой музыкой — например, слушать Discover Weekly или Rap Caviar — или узнавать последние новости из любимых подкастов.
Именно этот анализ привёл нас к созданию Shortcuts: мы задумали его как отдельное место на главной странице, где слушатели могут быстро найти то, что им сейчас особенно нравится.
#Как эвристики и модели машинного обучения помогли нам создать Shortcuts
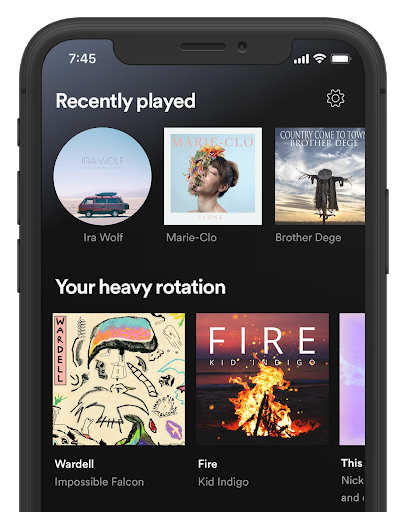
Главная страница состоит из горизонтальных секций, которые мы называем «полками». Каждая полка содержит несколько объектов. В среднем больше всего текущих фаворитов пользователя показывает полка Recently Played («Недавно прослушанное»), а следующей идёт Your Heavy Rotation («То, что вы часто слушаете»). Поэтому обе хорошо подходили для изучения и анализа любимого контента на главной странице.
Как видно на иллюстрации слева, обычная полка на главной странице позволяет показать на экране два-три элемента без прокрутки. Учитывая это, мы задумали Shortcuts как компактную область в верхней части главной страницы, в которой пользователю доступны шесть объектов для прослушивания. В качестве простейшего «минимально жизнеспособного продукта» мы могли просто показать в этой более плотной области шесть первых объектов из Your Heavy Rotation и Recently Played. По нашим оценкам, так мы могли бы вывести большую часть текущих фаворитов пользователей, заняв примерно столько же места, сколько занимает одна полка. Конечно, такой очень простой подход дал бы нам лишь нижнюю границу базовой точности предсказания того, что пользователь может включить следующим.
Поэтому затем мы занялись уточнением рекомендаций в Shortcuts, разрабатывая как эвристики, так и модели машинного обучения (ML). Установив базовый уровень, мы могли оптимизировать эвристики и модели. Конкретная метрика, которую мы выбрали для оптимизации, была такой: максимально увеличить долю истории прослушиваний пользователя, представленную шестью объектами в Shortcuts. Наличие базового уровня также позволило нам количественно оценивать улучшения, которые давали новые эвристики и модели.
#Проверка нашей гипотезы
Анализ, упомянутый в предыдущем разделе, опирался на историю прослушиваний пользователей за предыдущий месяц во всех разделах Spotify. Это означает, что пользователи могли слушать свои самые популярные объекты через разные точки доступа, включая медиатеку или страницу поиска.
Наша исходная гипотеза была такой: создав отдельную область в верхней части главной страницы и заполнив её любимым контентом пользователя, мы можем уменьшить усилия, необходимые ему, чтобы найти и включить то, что он хочет послушать прямо сейчас. Конечно, мы хотели проверить это как можно раньше и начали с A/B-теста: в тестовом варианте Your Heavy Rotation находилась вверху главной страницы, а Recently Played — непосредственно под ней. Это позволило нам подтвердить гипотезу о том, что пользователи будут включать музыку из верхней части главной страницы, даже если раньше находили её в других разделах Spotify. Подтвердив гипотезу, мы могли продолжить совершенствовать рекомендации, которые показываем вверху главной страницы.
#Улучшение рекомендаций с помощью эвристик
У нас были веские причины начать с эвристик, а не сразу переходить к модели машинного обучения. Прежде всего, эвристики задают базовый уровень, с которым мы можем сравнивать будущие ML-модели.
Кроме того, эвристики:
- Улучшают существующий пользовательский опыт.
- Позволяют быстро проводить итерации.
- Помогают определить, улучшает ли модель рекомендации настолько, чтобы её стоило поддерживать в промышленной эксплуатации.
По сравнению с эвристиками модели значительно сложнее сопровождать, отслеживать и отлаживать. Более того, если бы мы обнаружили, что модель работает не лучше базовой эвристики, у нас была бы веская причина оставить в эксплуатации эвристический подход.
Ещё одной важной причиной экспериментировать с различными эвристиками была возможность проверить нашу метрику офлайн-оценки. Офлайн-оценка заключалась в расчёте доли истории прослушиваний пользователя, которую могут представить шесть объектов, выбранных эвристикой Shortcuts.
Проводя онлайн-эксперименты и измеряя объём прослушиваний из Shortcuts с эвристическими рекомендациями, мы смогли установить связь между офлайн- и онлайн-метриками. Это дало нам офлайн-метрику, по которой на этапе разработки можно было судить, будет ли следующая предложенная эвристика или модель хорошо работать онлайн.
Что касается самих эвристик, нам пришлось принять важные решения о том, какие данные использовать и почему. Например, в набор кандидатов входит только история прослушиваний пользователя за последние 90 дней, поскольку Shortcuts должен отражать его недавний любимый контент, а не более постепенные изменения, которые могут происходить на протяжении нескольких месяцев.
Взяв за основу алгоритм отбора контента для Your Heavy Rotation, мы протестировали разные его модификации. Некоторые эвристики использовали различные функции затухания: недавно прослушанный контент получал больший вес, чем более старый. Мы также тестировали разные способы ранжирования наиболее знакомого контента — например, по частоте и длительности прослушивания. В ходе многочисленных итераций мы проверяли разные параметры, пока не получили эвристику, которая лучше всего показала себя в наших онлайн-экспериментах — A/B-тестах.
#Разработка нейросети для предсказаний Shortcuts
Когда эвристики стали существенно сложнее, пришло время перейти к модели машинного обучения. Модели использовали те же данные, что и эвристики, но эти данные активно применялись для обучения, а при предсказании — для подачи признаков в модель. В частности, каждый обучающий пример представляет собой последовательность прослушиваний пользователя, а целевые значения — последние прослушанные им объекты.
Для преобразования признаков, построения и обучения моделей мы использовали библиотеку TensorFlow. Для оценки моделей мы применяли Normalized Discounted Cumulative Gain (NDCG) — нормализованный дисконтированный кумулятивный прирост, распространённую метрику во многих рекомендательных системах. Особенность наших моделей заключается в том, что на выходе они должны выдавать контент, который присутствовал на входе модели: мы рекомендуем только то, что пользователь уже слушал. Поэтому на основе входных данных конкретного пользователя наши модели формируют ранжированный список наиболее знакомого ему контента.
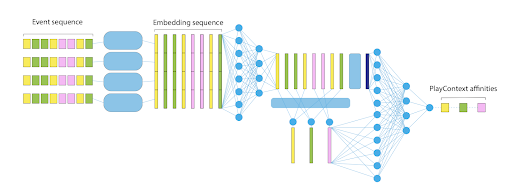
Нейросеть того типа, который используется для обучения ML-модели Shortcuts.
Архитектура нейронной сети — результат трёх месяцев исследований в области машинного обучения и более 1 000 экспериментов. Мы начали с воспроизведения наших эвристик с помощью ML-модели, обученной на данных. Затем мы изменяли архитектуру сети, чтобы улучшить метрики офлайн-оценки. Итоговая архитектура показала относительное улучшение на 26,7% по сравнению с эвристической моделью при офлайн-оценке.
Эта архитектура работает в два этапа. На первом этапе полносвязная сеть учится строить подходящее представление каждого события прослушивания — эмбеддинг. Для этого она объединяет временную метку, намерение при прослушивании — активное или пассивное — и характеристики соответствующего объекта. Затем эти эмбеддинги агрегируются по каждому объекту и передаются во вторую полносвязную сеть, которая присваивает каждому объекту оценку. Этот итоговый результат представляет вероятность того, что объект будет прослушан следующим. Наконец, мы сортируем объекты по их оценкам и показываем пользователю в Shortcuts первые шесть.
Наши модели различались по нескольким параметрам, включая набор используемых признаков, архитектуру модели и настройку гиперпараметров. Мы начали с простой модели, которая была предназначена для воспроизведения эвристики, и таким образом убедились, что моделирование может работать не хуже эвристик. В этом случае мы создали модель, которая рекомендовала контент с экспоненциальным затуханием — похожим на затухание, использовавшееся в одной из эвристик.
Применяя подход, похожий на тот, который мы использовали при разработке хорошей эвристики, мы тестировали несколько версий модели как офлайн, так и онлайн. Наши офлайн-метрики включали не только NDCG, но и метрику, применявшуюся для оценки эвристик. С помощью A/B-тестов мы смогли установить связь между значениями NDCG и нашей онлайн-метрикой: количеством прослушиваний из блока Shortcuts с рекомендациями, сформированными моделями.
После более чем 1 000 офлайн-экспериментов и серии A/B-тестов, в которых участвовали десятки различных вариантов модели, мы определили модель с наилучшими результатами и выбрали её для запуска Shortcuts.
#Вывод модели в промышленную эксплуатацию
До запуска нам нужно было подготовиться к любым проблемам, которые могли возникнуть при использовании модели для предсказания содержимого Shortcuts для сотен миллионов пользователей. Значительная работа была посвящена проектированию и созданию системы мониторинга, оповещений и помощи в отладке. Она охватывает проблемы, связанные с обслуживанием модели, неполадки в вышестоящих источниках данных, из которых формируются входные признаки, и ухудшение качества рекомендаций, выдаваемых моделью.
Команда использовала ряд инструментов для выявления таких проблем. Мы создали несколько конвейеров с почасовой пакетной обработкой, которые формируют статистику подачи признаков, характеризуют выходные данные модели и рассчитывают офлайн-метрики в таблицах BigQuery. Затем данные из этих таблиц использовались как входные данные для панелей мониторинга, в которых также были настроены механизмы оповещения. Хотя проблемы всё ещё могут возникать, эти инструменты позволяют гораздо быстрее обнаруживать их и реагировать.
#Главный вывод
Наш главный вывод из этого проекта: методология важнее технологии. Прежде чем погрузиться в реализацию алгоритма машинного обучения, мы рассмотрели данные с разных сторон, провели множество онлайн- и офлайн-тестов и попробовали простые эвристики. Благодаря этому мы гораздо лучше поняли ожидания пользователей и смогли яснее представить продукт, который хотели создать, — и метрику, на которую он должен влиять. Как только появляется ясное видение, становится гораздо проще выбрать способ офлайн-оценки, целевую функцию, обучающие данные и архитектуру алгоритма машинного обучения.
Не менее важной, чем создание этой основы, была способность объяснить возможности проекта остальному бизнесу. Это позволило нам начать собирать межфункциональную команду, в которую вошли специалисты по UX, исследованиям пользователей, продуктовому маркетингу и другим направлениям. Именно это сочетание самостоятельности каждого участника и командной работы делает работу в Spotify особенной — как и чувство удовлетворения, которое испытываешь, когда проект, над которым работали шесть месяцев, становится реальностью для миллионов конечных пользователей.
#Что нас ждёт дальше
Хотя новая функция уже запущена для всех пользователей нашего мобильного приложения, работа над улучшением её текущего представления продолжается. Мы регулярно спрашиваем пользователей, как они взаимодействуют с Shortcuts, чтобы понять, что ещё можно улучшить. Например, мы пытаемся выяснить, в какой степени эти шесть объектов могут меняться в течение дня в зависимости от привычек прослушивания утром, в обед и так далее.
Так что нам ещё многое предстоит сделать! Но всё это возможно только благодаря упорной работе и преданности делу каждого участника проекта Shortcuts. Ещё раз хочу поблагодарить команду за то, что она сделала это возможным. Это была непростая задача, но последние шесть месяцев были одновременно захватывающими и плодотворными. Участвовать в этой работе было большим удовольствием.
Команда: Adam Alix, Ethan Boye-Doe, Keenan Cassidy, Christophe Charbuillet, Tracey Churray, Annie Edmundson, Mark Kizelshteyn, Justin Li, Anil Muppalla, Nhi Ngo, Johan Pages, Yoshnee Raveendran, Yancey Reid, Isaiah Spicer, Damien Tardieu, Logan Wilson.
От редакции Sales Ninja — не часть оригинала. В интернет-магазине похожая идея — помочь человеку вернуться к знакомым товарам и сократить путь к повторной покупке. В товарных рекомендациях Sales Ninja сценарий «Возврат к просмотренному» показывает уже просмотренные товары с учётом личной релевантности и популярности в категории. Для упорядочивания собственного списка товаров можно использовать ML-ранжирование.
Оригинал статьи опубликован на engineering.atspotify.com