В интернет-магазине может быть хороший ассортимент, удобные фильтры и умные товарные рекомендации. Но стоит открыть категорию — и все посетители увидят примерно одну и ту же первую страницу: бестселлеры, новинки или товары, которые кто-то однажды поднял вручную.
Здесь остаётся отдельная задача. Из всех подходящих товаров нужно выбрать те, которые человек рассмотрит первыми. На телефоне это особенно заметно: ассортимент измеряется тысячами позиций, а внимание — несколькими карточками.
ML-ранжирование меняет порядок уже отобранных товаров с помощью обученной модели. Товарные рекомендации подбирают товары для определённого сценария: например, альтернативы в карточке или дополнения к корзине. Внутри рекомендаций тоже есть ранжирование, но на сайте эти продукты решают разные задачи и могут работать вместе.
Разберём, откуда у порядка товаров появляется экономическая ценность, что показывают исследования и как отличить полезную модель от красивого отчёта. В конце — как эта задача решается в ML-ранжировании Sales Ninja.
#Порядок товаров определяет, до чего дойдёт покупатель
Посетитель редко изучает категорию целиком. Он просматривает начало списка, открывает несколько карточек, уточняет фильтры — либо уходит. Если подходящая позиция оказалась далеко внизу, её наличие в ассортименте мало помогает этой конкретной покупке.
Поэтому порядок товаров влияет на то, из чего человек фактически выбирает. Каталог предлагает тысячу вариантов; первые экраны превращают эту тысячу в небольшой набор, который покупатель успеет рассмотреть.
Это различие хорошо видно в исследовании Ралуки Урсу на данных полевого эксперимента Expedia. Изменение позиции влияло на то, какие предложения люди изучали. При этом среди уже изученных предложений автор не обнаружила отдельного влияния позиции на покупку. Ранжирование помогало через сам процесс поиска: делало одни варианты доступнее для рассмотрения.
Для магазина из этого следует практический вывод: поднять товар — значит дать ему больше шансов попасть в выбор покупателя. Дальше имеют значение цена, наличие, доставка и то, насколько товар подходит человеку.
Сортировка по популярности использует разумную отправную точку: если позицию часто покупают, её стоит показать. Но «часто покупают вообще» и «подходит этому посетителю сейчас» — разные вещи. Общий бестселлер может уступать менее популярной модели, если человек уже смотрел определённый бренд, выбирает другой ценовой диапазон или собирает конкретный комплект.
#Рекомендации выбирают состав, ранжирование — порядок
У выдачи есть два свойства: какие товары в неё попали и в какой последовательности их показали.
В категории «Беговые кроссовки» состав задают каталог и фильтры. Если посетитель выбрал размер 43, товары другого размера должны отсечься до ранжирования. Затем модель может решить, какие из оставшихся вариантов показать выше.
В рекомендательном блоке под карточкой задача начинается раньше. Система должна подобрать альтернативные модели или совместимые аксессуары из доступного ассортимента, а затем упорядочить получившийся набор.
| Вопрос | ML-ранжирование | Товарные рекомендации |
|---|---|---|
| Что нужно решить? | В каком порядке показать готовый набор? | Какие товары предложить в выбранном сценарии? |
| Откуда берутся кандидаты? | Их передаёт сайт: категория, поиск, подборка | Их подбирает рекомендательная система из каталога с учётом сценария |
| Что получает посетитель? | Основную выдачу с другим порядком | Подборку альтернатив, дополнений или других релевантных товаров |
| Меняется ли состав? | В рассматриваемом продукте Sales Ninja — нет | Состав формируется системой рекомендаций |
| Где особенно полезно? | Категории, результаты поиска, страницы брендов и акций | Карточка товара, корзина, главная, дополнительные блоки |
| Могут ли работать вместе? | Да: ранжирование основной выдачи | Да: подборка рядом с основной выдачей |
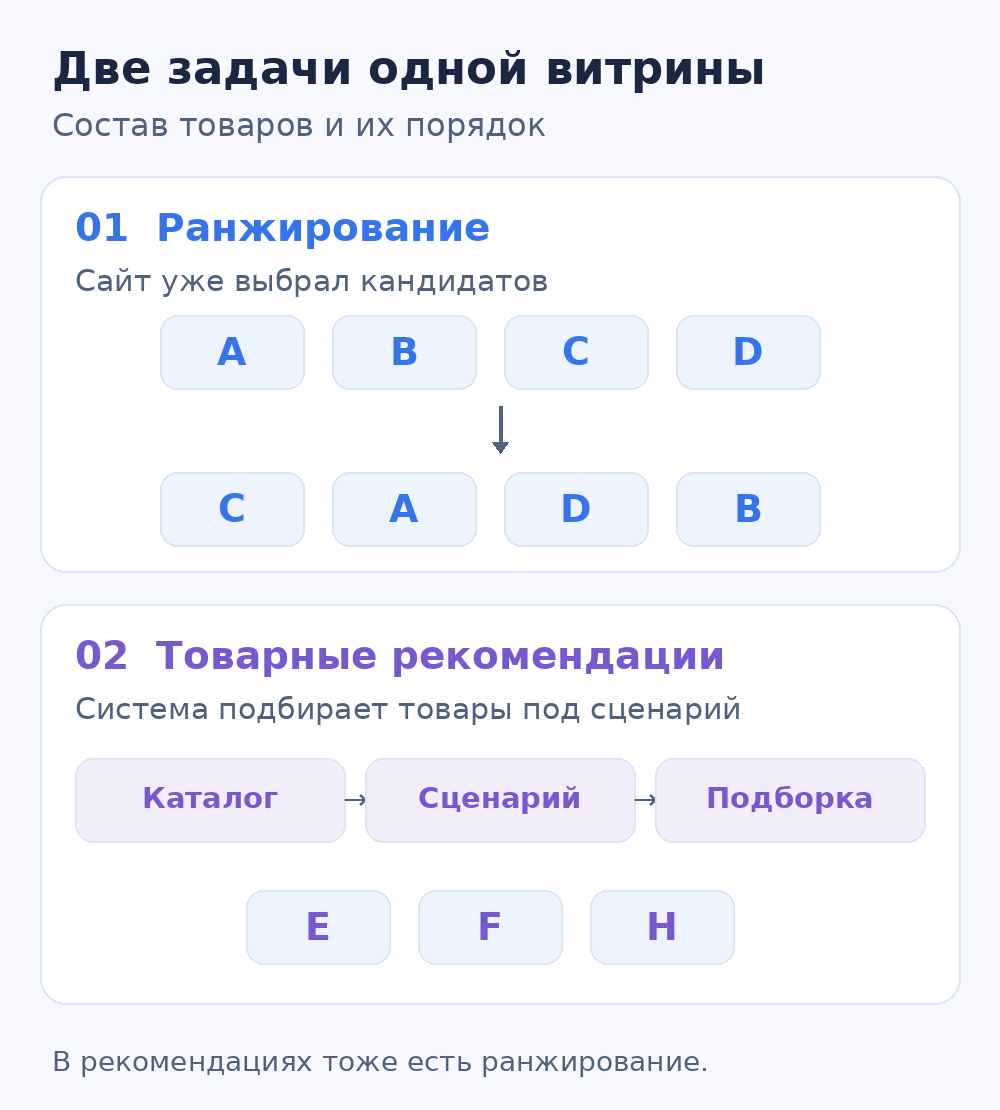
Схема показывает различие задач. Одна рекомендательная система может выполнять и отбор, и ранжирование.
Эта граница описывает применение продукта, а не два несовместимых класса алгоритмов. Рекомендации и ранжирование могут использовать общие данные, признаки и модели. Даже категория без отдельного рекомендательного блока может быть персонализирована за счёт порядка товаров.
Разделение полезно при выборе места внедрения. Хорошие дополнения в корзине помогают расширить заказ. Хороший порядок в категории помогает быстрее найти основной товар. Эффект возникает в разных частях пути покупателя.
#Что модель умеет учитывать сверх популярности
Ручная выкладка обычно опирается на несколько правил: поднять бестселлеры, выделить новинки, продвинуть определённый бренд. Это удобно, пока ассортимент и предпочтения достаточно однородны.
Когда каталог растёт, правила начинают пересекаться. Новый посетитель ещё не проявил интересов. Вернувшийся уже изучал дорогие модели. Другой пришёл на сезонную подборку и просматривает бюджетные варианты. Одна и та же последовательность оказывается компромиссом для всех.
ML-модель учится по истории взаимодействий: какие сочетания товара, контекста и поведения предшествовали нужному результату. В зависимости от системы она может учитывать свойства товара, спрос, просмотры, корзину, текущий раздел и историю посетителя. Затем каждому кандидату присваивается оценка, по которой строится порядок.
Общий принцип можно записать так:
Оценка товара = модель(товар, посетитель, текущая ситуация, цель).
Оценка не обязательно является вероятностью покупки. Это может быть балл, пригодный для сравнения кандидатов внутри конкретной выдачи. Чтобы трактовать его как вероятность, нужны соответствующее обучение и проверка калибровки.
В Learning to Rank — обучении ранжированию — есть несколько распространённых подходов. Модель может оценивать каждый товар отдельно, учиться сравнивать пары или учитывать список целиком. Последний подход полезен, когда соседние позиции меняют восприятие друг друга: десять почти одинаковых моделей занимают первый экран, но дают мало нового выбора. Конкретный метод выбирают по данным, ограничениям и результатам проверки.
Для поисковой выдачи при этом сохраняется важная последовательность: сначала найти подходящие товары, затем упорядочить их. Если нужная батарея вообще не попала в кандидаты, модель ранжирования её не вернёт. Если на пересортировку отправлены только первые 24 позиции, товар с двухсотой позиции в них не появится.
#Почему «покупают чаще» не всегда означает «выгоднее показать выше»
Ранжирование должно знать, какой результат нужен бизнесу. Клик, заказ, оплаченный заказ и прибыль дают разные ориентиры.
Простой условный расчёт показывает, почему это важно. Возьмём два подходящих товара. Вероятность покупки после того, как человек рассмотрел товар, составляет 8% у товара А и 4% у товара Б. Маржинальный доход с покупки — 200 и 700 рублей соответственно. Под маржинальным доходом здесь понимаем сумму после переменных затрат, до постоянных расходов.
| Товар | Вероятность покупки после рассмотрения | Маржинальный доход с покупки | Ожидаемый доход на одно рассмотрение |
|---|---|---|---|
| А | 8% | 200 ₽ | 16 ₽ |
| Б | 4% | 700 ₽ | 28 ₽ |
Первую позицию рассмотрят 1 000 человек, вторую — 400. Для расчёта принимаем эти числа одинаковыми при обоих порядках, а вероятности покупки — независимыми от соседнего товара.
Если поставить А первым, ожидаемый маржинальный доход составит:
1 000 × 8% × 200 + 400 × 4% × 700 = 27 200 ₽.
Если поставить Б первым:
1 000 × 4% × 700 + 400 × 8% × 200 = 34 400 ₽.
Во втором порядке ожидается меньше покупок — 72 вместо 96, — но на 7 200 рублей больше маржинального дохода. Разница составляет примерно 26,5%.
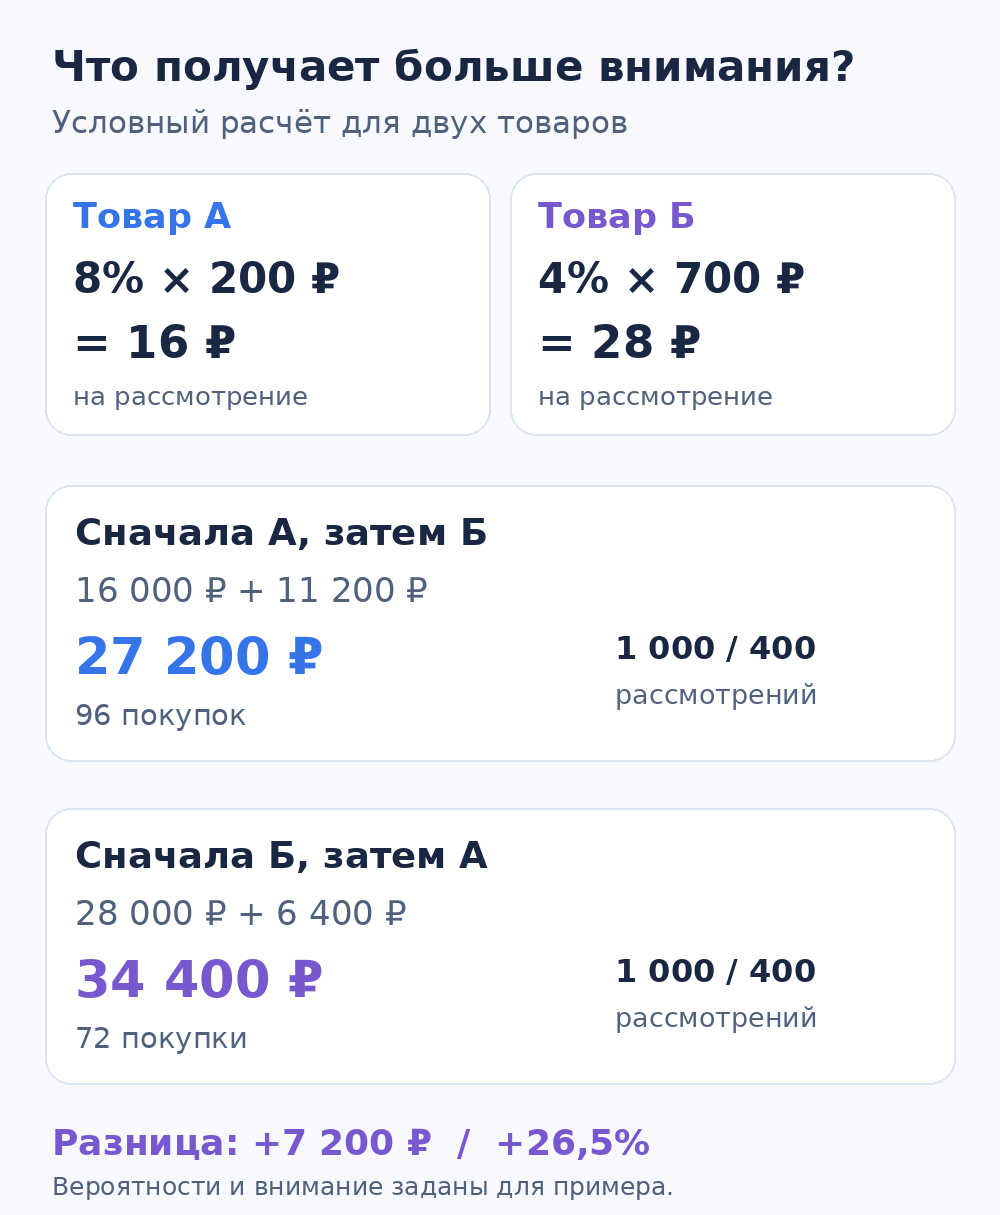
Условный расчёт для объяснения механизма. В реальной выдаче товары конкурируют, а вероятность покупки зависит и от состава списка.
Отсюда не следует, что нужно механически поднимать дорогие или высокомаржинальные позиции. У неподходящего товара вероятность покупки может быть настолько низкой, что высокая маржа её не компенсирует. Полезно оценивать сочетание потребности покупателя и экономического результата.
Упрощённый ориентир для такой оценки — вероятность покупки × ожидаемый маржинальный доход при покупке. Если отмены и возвраты существенны, их нужно включить в определение итогового результата. Иначе модель может продвигать товары, которые хорошо оформляют в заказ, но редко выкупают.
Выбор обучающего сигнала исследовали, в частности, авторы On Application of Learning to Rank for E-Commerce Search. В их экспериментах доля заказов оказалась более устойчивой целью обучения, чем клики и добавления в корзину. Это результат конкретной работы, но он показывает, почему доступность события ещё не делает его лучшим ориентиром для модели.
#У популярности есть скрытая проблема: её создал прежний порядок
Товар на первой странице получает больше внимания. Больше внимания даёт больше кликов и покупок. Сортировка по накопленным продажам снова поднимает его вверх.
Так возникает петля: высокая позиция → больше внимания → больше событий → высокая позиция. В продажах смешиваются свойства товара и преимущество, которое дала ему прежняя выкладка.
Это и есть позиционное смещение. Его разбирает работа Unbiased Learning-to-Rank with Biased Feedback: непосредственное обучение на кликах без учёта позиции может приводить к неоптимальному ранжированию.
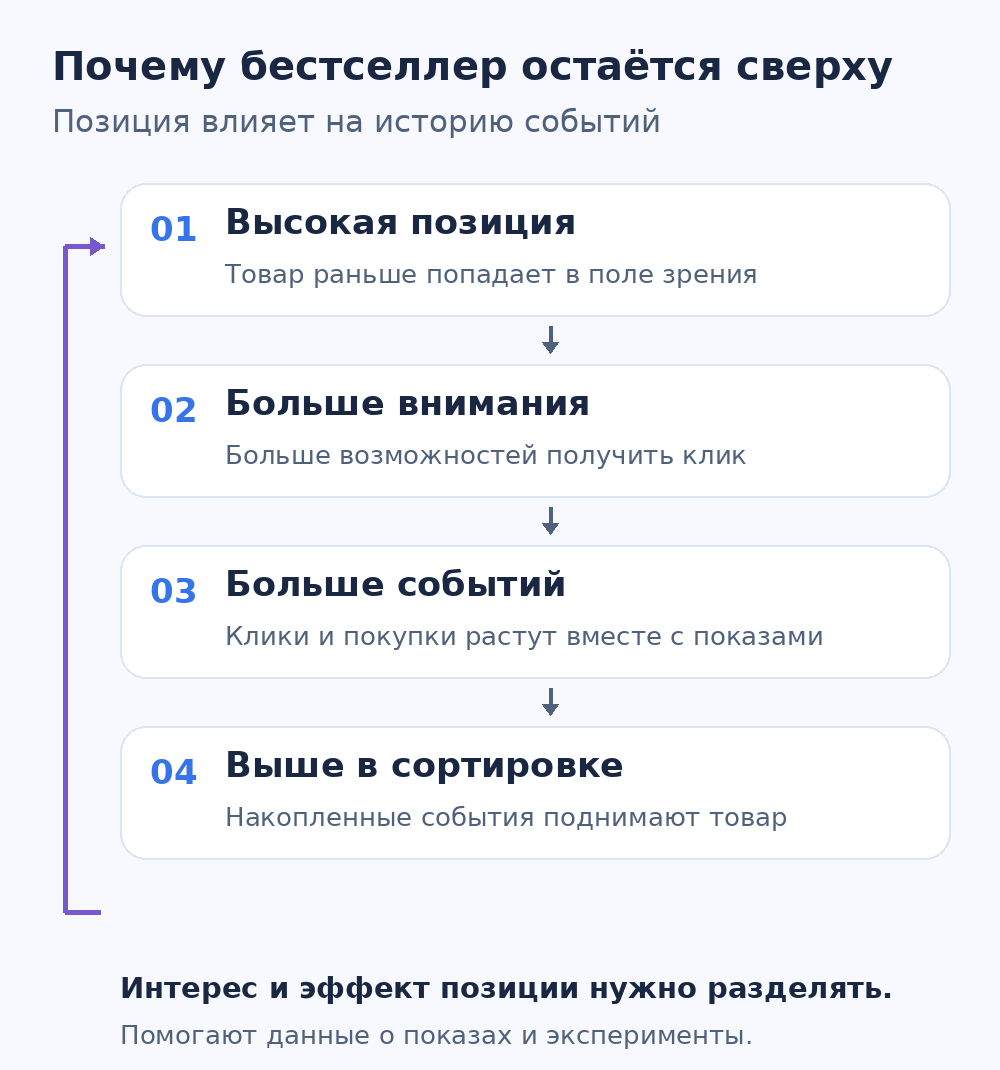
Популярность полезна как признак, но количество событий зависит и от возможностей увидеть товар.
Поэтому качественной системе нужны данные о показах и позициях, а не только о кликах и заказах. Товар, который посетитель не видел, нельзя автоматически считать отвергнутым. Перестановки в экспериментах и методы коррекции смещения помогают отделять интерес от преимуществ старой выдачи.
У новых товаров проблема ещё заметнее: история отсутствует, и сортировка по продажам почти неизбежно оставляет их внизу. Свойства товара и данные о похожих позициях могут помочь с начальной оценкой, но степень такой помощи зависит от конкретной реализации. По мере появления событий оценку можно уточнять.
ML-ранжирование позволяет использовать больше информации, чем один счётчик продаж. Чтобы эта информация приносила пользу, нужно понимать, как она появилась.
#Что показывают исследования и бенчмарки
У ранжирования есть две разные проверки. Первая оценивает качество порядка на заранее подготовленных данных. Вторая измеряет поведение настоящих покупателей после изменения выдачи. Их результаты нельзя подменять друг другом.
Для первой проверки часто используют NDCG: метрика выше, когда более полезные товары стоят ближе к началу списка. Обозначение NDCG@10 означает, что оцениваются первые десять позиций. Полезность задаётся разметкой: например, соответствием поисковому запросу или определённым пользовательским событием.
Конкретные работы дают следующие ориентиры:
| Источник | Что сравнивали | Результат | Как его читать |
|---|---|---|---|
| Amazon ESCI, 2022 | Базовую модель ранжирования товаров по соответствию запросу на открытом датасете | nDCG = 0,83 в опубликованной таблице базовых результатов | Проверка релевантности на размеченных данных, без измерения продаж |
| AliExpress, 2020, таблица 6 | Настроенную RankNet с отсутствием дополнительного переранжирования | +5,96% к конверсии | Эффект конкретного этапа переранжирования в системе AliExpress |
| AliExpress, та же работа | EG-Rerank с уже настроенной RankNet | +2,22% к конверсии | Дополнительный выигрыш относительно сильной ML-модели |
| Airbnb, 2020, раздел 2.7 | Новую двухбашенную архитектуру с действующей нейросетью ранжирования | +0,6% к бронированиям; +0,75% к выручке | Улучшение уже развитой системы в онлайн A/B-тесте |
Числа в строках AliExpress и Airbnb — относительные изменения соответствующих метрик. Например, рост конверсии на 2% относительно базы 3% означает примерно 3,06%, то есть прибавку 0,06 процентного пункта.
Amazon ESCI полезен для изучения поискового ранжирования: его разметка различает точное соответствие запросу, заменитель, дополнение и нерелевантный товар. Это помогает увидеть разницу между задачами. Чехол может быть хорошей рекомендацией к телефону, но не лучшим ответом на запрос самого телефона.
При этом nDCG = 0,83 не означает «83% посетителей купят». Это оценка порядка относительно разметки. Результаты разных датасетов тоже нельзя напрямую сравнивать: отличаются запросы, кандидаты и определение полезности.
#Почему здесь нет обещания «в несколько раз лучше популярности»
Преимущество зависит от исходного порядка. Если категория уже хорошо отсортирована, а предпочтения покупателей похожи, запас улучшения может быть небольшим. Если один порядок обслуживает разные намерения и скрывает подходящие позиции, возможностей больше.
В приведённых онлайн-экспериментах модели сравнивали с конкретными действующими системами. В них нет универсального коэффициента превосходства над сортировкой по популярности для любого магазина. Собственный бенчмарк стоит строить против того порядка, которым покупатели пользуются сейчас, и против разумной альтернативы — например, популярности по покупкам за актуальный период.
Даже умеренное улучшение может быть экономически значимым, когда касается посещаемой основной выдачи. Его ценность определяется охватом, дополнительным результатом и затратами на внедрение.
#Когда хорошая идея ухудшает результат
В работе Airbnb есть показательный неудачный эксперимент. Команда увидела, что люди часто бронируют предложения дешевле среднего уровня показанной выдачи. Казалось логичным сильнее поднимать доступные варианты.
В одной из проверок модель жёстко ограничили так, чтобы увеличение цены всегда снижало оценку. Средняя цена предложений в поиске уменьшилась на 5,7%, но бронирований стало на 1,5% меньше. Позже архитектура, которая лучше учитывала связь запроса и предложения, дала положительный результат из таблицы выше.
Доступность по цене оказалась частью задачи. Покупатель выбирал сочетание цены и качества в конкретных условиях. Жёсткое правило потеряло часть этого сочетания.
Работа AliExpress показывает другой сбой: модель могла выглядеть лучше по метрике качества порядка и хуже по фактической конверсии. Учитывать приходится не только свойства отдельных товаров, но и то, как покупатель воспринимает весь список.
Поэтому прирост NDCG, увеличение кликов или более «правильный» на вид первый экран — повод для проверки. Окончательный ответ даёт результат покупателей после изменения выдачи.
#Как проверить ML-ранжирование в своём магазине
Начать лучше с конкретного места на сайте: посещаемой категории, поисковой выдачи или страницы акции. Для неё определяют исходный порядок, нужный результат и набор допустимых товаров.
Дальше посетителей случайно делят на группы. Контроль получает обычный порядок, тестовая группа — порядок модели. Назначение сохраняют для посетителя, чтобы при повторном визите он не переходил между вариантами. Цены, акции и логика отбора кандидатов должны работать одинаково: тогда разницу легче связать с ранжированием.
Проверка должна учитывать весь назначенный трафик выбранного сценария, включая случаи технического возврата к исходному порядку. Если оставить только успешные ответы модели или только кликнувших посетителей, оценка будет описывать отобранную часть аудитории.
| Что измерять | На какой вопрос отвечает |
|---|---|
| Оплаченные или выкупленные заказы на посетителя или сессию | Помог ли новый порядок довести до результата? |
| Выручку и маржинальный доход с тем же знаменателем | Стал ли результат экономически лучше? |
| Показы списков, позиции и клики | Что изменилось в распределении внимания? |
| Отмены, возвраты и средний чек | Сохранилось ли качество заказов? |
| Задержку выдачи и долю возвратов к исходному порядку | Получает ли посетитель улучшение без ухудшения работы страницы? |
Клики помогают объяснить результат. Если их стало больше, а оплаченных заказов меньше, это тоже важная находка: новая выдача привлекла внимание, но хуже помогла выбрать.
Для финансового эффекта полезно дождаться типичного срока оплаты и возвратов. Неопределённость результата нужно показывать вместе с оценкой, а правила завершения теста выбирать заранее. Небольшой эффект обычно требует много наблюдений; несколько удачных дней могут отражать случайное колебание.
После общей оценки смотрят значимые разрезы: новые и вернувшиеся посетители, устройства, крупные категории. Эти срезы помогают найти следующий шаг, но множество случайных сравнений повышает вероятность увидеть ложную «победу».
#Где ранжирование особенно уместно
Больше всего смысла в нём там, где уже есть выбор подходящих товаров, но посетителю трудно быстро увидеть свой вариант. Обычно это крупные категории, неоднородный ассортимент и выдачи, в которых первый экран получает заметно больше внимания, чем остальной список.
Полезно проверить, не решает ли магазин вручную повторяющиеся задачи: менять порядок к сезону, поднимать позиции для разных сегментов, пересматривать выкладку после изменения спроса. Модель может помочь там, где число сочетаний выросло быстрее возможностей ручного управления.
Есть и границы. Неверное наличие, плохая доставка или пропущенная поиском нужная позиция требуют исправления соответствующего этапа. Явно выбранную сортировку «по цене» следует уважать: персонализацию можно применять в режиме по умолчанию или в пределах равных значений, если это соответствует интерфейсу. Поведение пагинации тоже нужно продумать, чтобы обновление порядка не создавало повторы и пропуски между страницами.
Хорошее внедрение начинается с понимания, какой именно список модель получает и какие решения за неё уже принял сайт.
#ML-ранжирование в Sales Ninja
В ML-ранжировании Sales Ninja сайт передаёт готовый набор товаров и получает рассчитанный моделью порядок. Состав набора сохраняется, а магазин показывает собственные карточки в новой последовательности.
В документации продукта описаны обучение по выбранной цели и учёт свойств товаров, текущего спроса, просмотров, корзины и контекста посетителя. В качестве ориентира доступны конверсии, выручка или прибыль, а при соответствующей настройке — воронка и моделируемая конверсия. Выбор цели определяет, какой результат модель учится поддерживать.
Для сравнения с исходной выдачей предусмотрен A/B-тест: посетители распределяются между обычным и персонализированным порядком, а отчёт показывает результат и его погрешность. Полученный ответ модели и фактический показ списка учитываются как разные события.
Товарные рекомендации Sales Ninja дополняют этот сценарий. Основной каталог помогает выбрать товар, а отдельная подборка предлагает альтернативы или дополнения в подходящем месте сайта.
У большого ассортимента есть ценность, когда покупатель может до неё добраться. Рекомендации расширяют круг подходящих предложений. ML-ранжирование помогает разумнее распределить внимание внутри уже выбранного списка — и проверить, приносит ли такой порядок больше покупок и денег.
Подробнее о ML-ранжировании Sales Ninja →
#Источники и дальнейшее чтение
- Raluca M. Ursu. The Power of Rankings: Quantifying the Effect of Rankings on Online Consumer Search and Purchase Decisions, Marketing Science, 2018. Полевой эксперимент Expedia и влияние порядка на поиск предложений.
- Thorsten Joachims, Adith Swaminathan, Tobias Schnabel. Unbiased Learning-to-Rank with Biased Feedback, WSDM, 2017. Позиционное смещение и обучение по пользовательским событиям.
- Shubhra Kanti Karmaker Santu, Parikshit Sondhi, ChengXiang Zhai. On Application of Learning to Rank for E-Commerce Search, версия на arXiv, 2019. Сигналы обучения и практические особенности товарного поиска.
- Guangda Huzhang и соавторы. AliExpress Learning-To-Rank: Maximizing Online Model Performance without Going Online, версия на arXiv, 2020. Расхождение метрик качества и бизнес-результата; численные результаты — таблица 6 PDF.
- Malay Haldar и соавторы. Improving Deep Learning For Airbnb Search, KDD, 2020. Положительные и отрицательные эксперименты с ранжированием.
- Chandan K. Reddy и соавторы. Shopping Queries Dataset: A Large-Scale ESCI Benchmark for Improving Product Search, 2022; данные и базовые результаты в репозитории Amazon Science.
- Sales Ninja: ML-ранжирование, товарные рекомендации, документация ранжирования.