Вот и подъехали многочисленные крупные улучшения и мелкие приятные фичи, которые (по плану) сделают вас счастливее.
Оптимальная глубина теперь вычисляется динамически. Например, если вы хотите построить статистику из 5 группировок, но это затронет большой объем данных - изначально мы вычислим только 2 слоя (как пример). Потом по мере раскрытия вложенности - динамические довычислим нужные ветки.
Автоматический сэмплинг. А еще теперь мы автоматически вычисляем когда нужно применить сэмплинг к статистике и в какой именно степени, и на какую глубину. То есть, как правильно агрегировать лишь часть данных, чтобы получить >99% точности (включая редкие группы). Если семплинг был применен автоматически, то система покажет это (сколько прочитано данных и какая итоговая точность. Условно прочитали 90% данных, точность 99.8%).
Пункты 1 и 2, а так же десяток мелких улучшений позволили ускорить статистику еще в несколько раз. Что особенно важно, это позволило еще сильнее улучшить опыт аналитики в реальном времени для самых огромных проектов с большим объемом данных.
Был значительно прихорошен UI всей аналитики - добавлены подсказки, быстрые сниппеты, подробные описания происходящего и очень много скрытой автоматики, которая выбирает оптимальное представление показа тех или иных мест так, чтобы было удобнее всего.
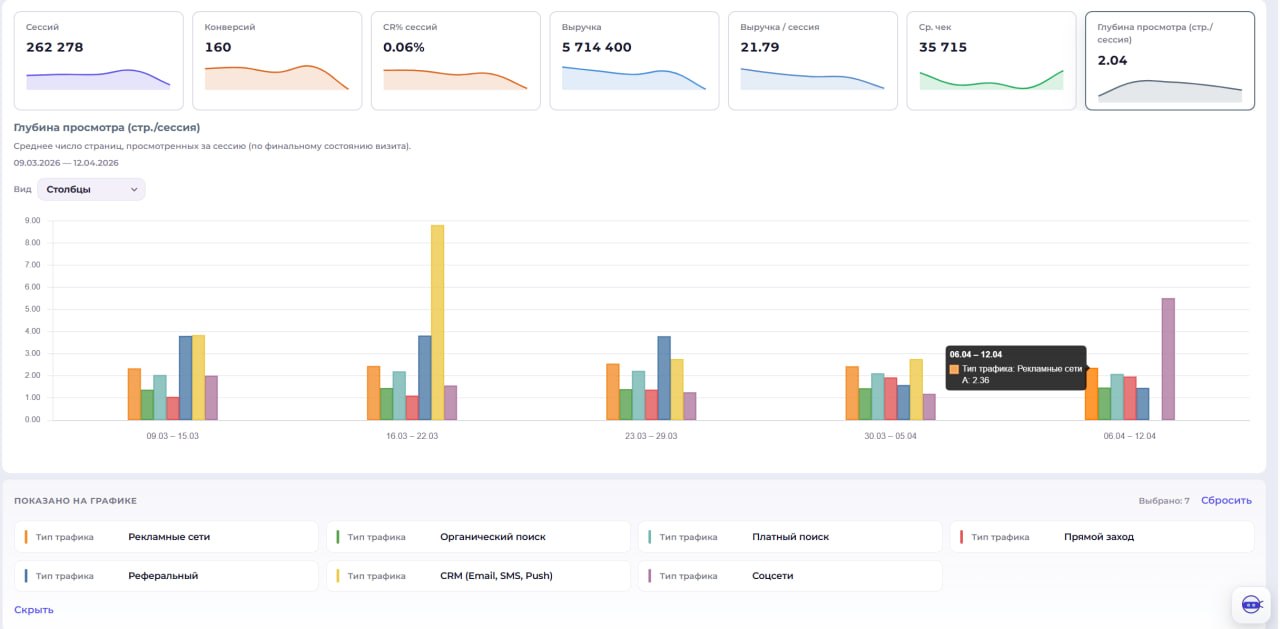
Помимо основного графика по линиям, добавили еще график по столбцам и областям (см скриншоты)
Добавили автоматическое вычисление доверительных интервалов на любую метрику, которая может их поддерживать (какой именно интервал использовать можно выбирать в реальном времени)
Добавили разные режимы подсветки таблицы - без подсветки, лучшее и худшее значение в группе и градация (см скриншоты)
Добавили новые метрики и типы группировки
Функционал конверсионных путей пользователя и самое главное инсайтов был значительно улучшен внутри. Теперь они куда более персонализированные, учитывают куда больше мелких деталей автоматически.
Оригинал статьи опубликован на t.me
