Новая версия страницы принесла на 12% больше заявок. В отчёте появилась статистическая значимость, команда собирается внедрять изменение. Но квалифицированных лидов стало меньше, часть заявок ещё не обработана, а «победителя» нашли после просмотра двадцати срезов.
Все три обстоятельства меняют вывод. Прирост заявок может оказаться бесполезным для бизнеса. Неполные данные могут перевернуть результат. А долгий поиск удачного среза способен сделать убедительным обычный шум.
Поэтому в A/B-тесте приходится отвечать на два связанных вопроса: что именно улучшилось и насколько убедительно мы это установили. Для первого нужны бизнес-метрики. Для второго — оценка эффекта, доверительные интервалы, MDE, мощность и правила статистической проверки. Поправки Бонферрони и Шидака появляются тогда, когда один эксперимент превращается в несколько возможностей объявить победителя.
#Какие метрики выбирать для A/B-теста
Метрика должна отвечать на вопрос, ради которого запущен эксперимент. Если меняется форма заявки, важно понять, помогает ли она получать нужных клиентов. Если меняется цена — зарабатывает ли бизнес больше с того же входящего трафика. Если меняется онбординг — чаще ли люди доходят до использования продукта и возвращаются к нему.
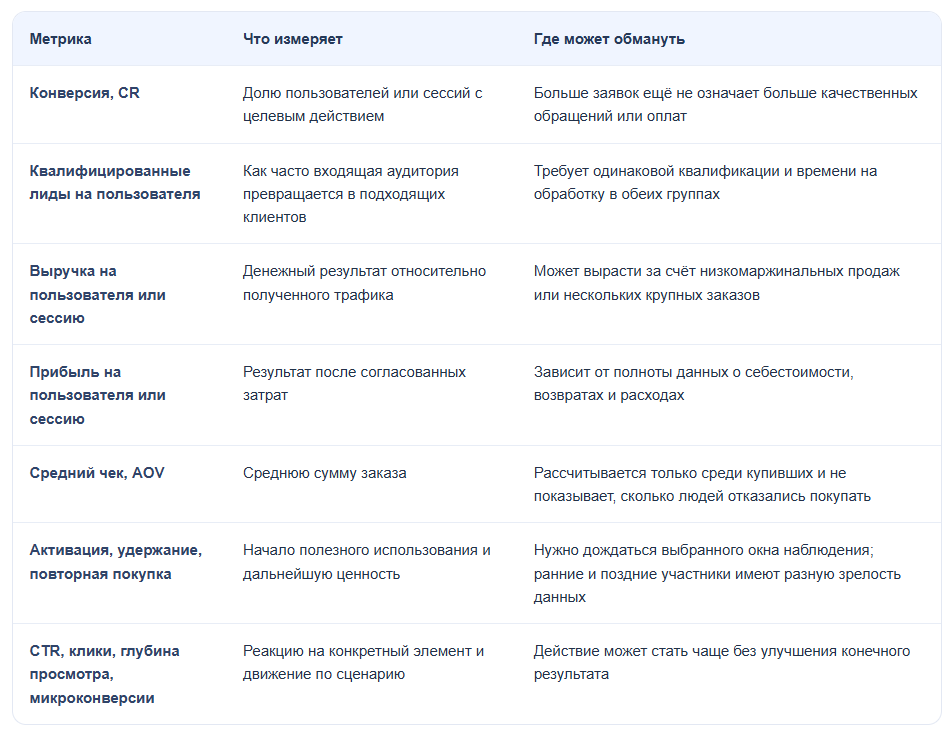
У конверсии есть ещё одна важная деталь: знаменатель. «Сессии с покупкой / все сессии» и «пользователи с покупкой / все пользователи» — разные показатели. А «число покупок / число сессий» допускает несколько покупок в одном визите. Название CR не должно скрывать, что именно считается.
#Почему одной целевой метрики мало
Обычно полезно заранее выделить три роли показателей.
Основная метрика определяет успех гипотезы. Например, квалифицированные лиды на пользователя или выручка на пользователя за 14 дней после попадания в тест.
Защищаемые метрики, guardrails, ограничивают допустимый ущерб. Можно добиваться роста продаж, одновременно следя за прибылью, возвратами и ошибками оплаты. Для каждой такой метрики заранее задают, какое ухудшение считается неприемлемым и как на него реагировать.
**Диагностические метрики объясняют механизм. **Просмотр условий, начало заполнения формы, переход к оплате помогают найти место, где поведение изменилось. Их рост сам по себе не делает эксперимент успешным.
Такое разделение используют и крупные платформы экспериментов: Microsoft описывает отдельно итоговые, диагностические и защищаемые метрики. Оно решает практическую проблему: команда получает много наблюдений, но сохраняет заранее определённое правило принятия решения.
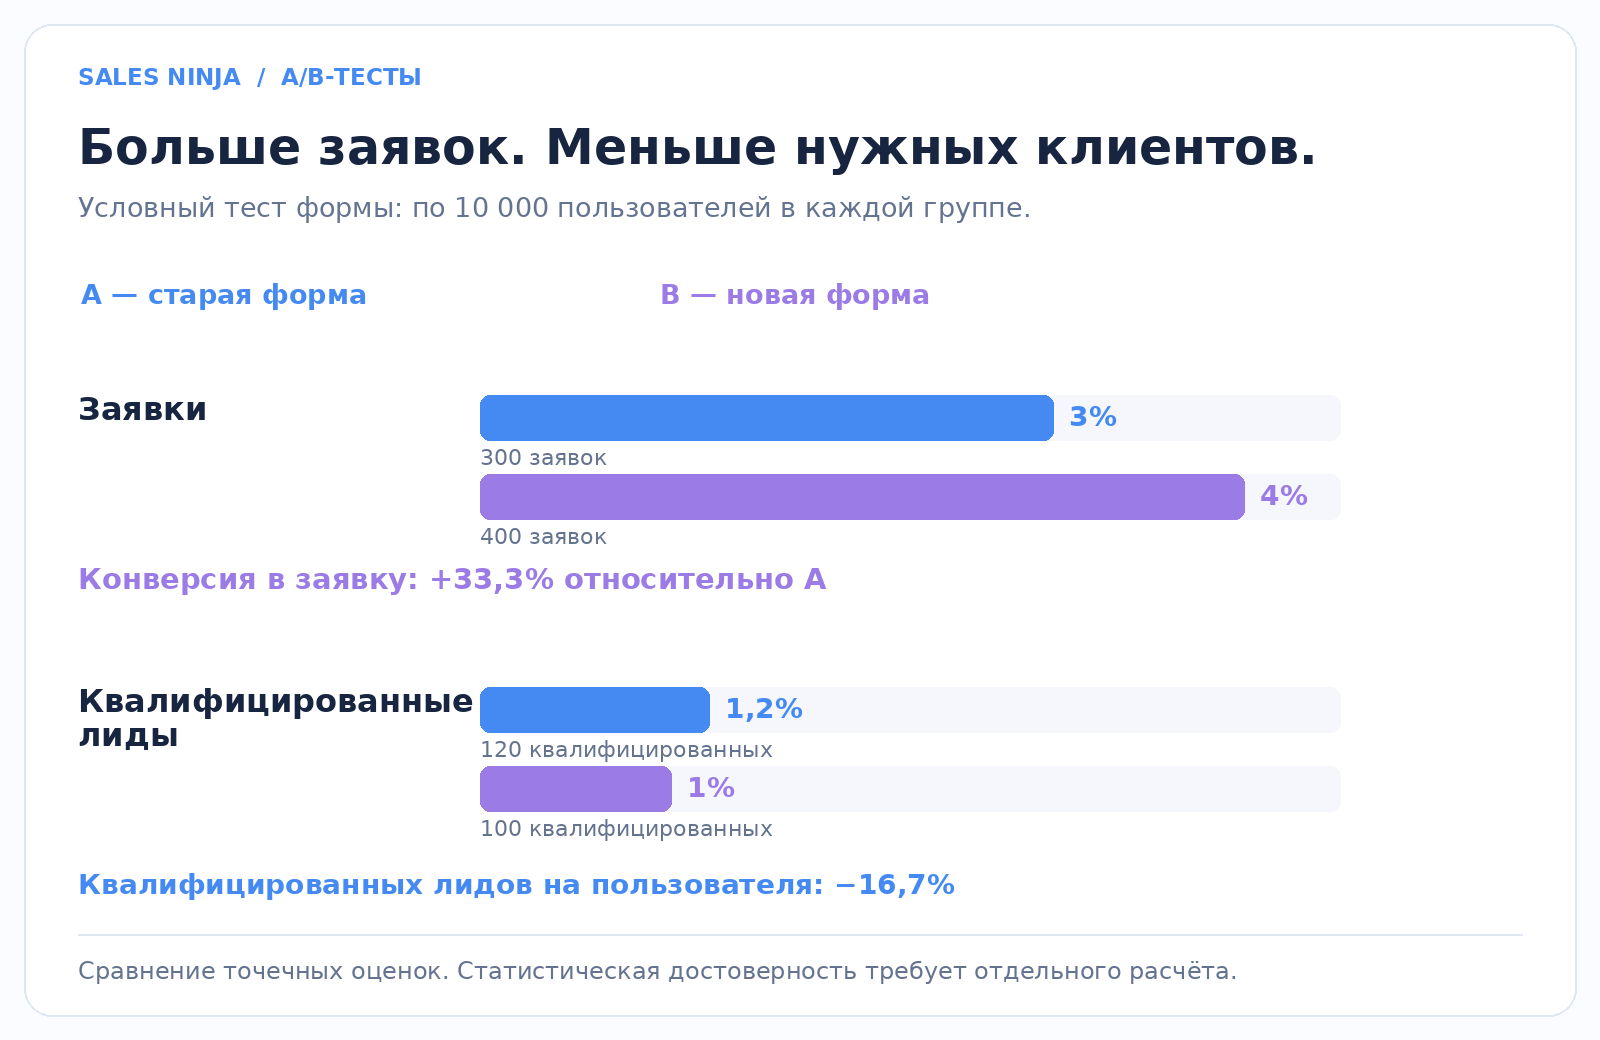
Представим условный тест формы. В обе группы пришло по 10 000 пользователей. Старая форма дала 300 заявок, из них 120 квалифицированных. Новая — 400 заявок, из них 100 квалифицированных.
Конверсия в заявку выросла с 3% до 4%: на треть. Но квалифицированных лидов на пользователя стало меньше — 1% вместо 1,2%. Упрощение формы помогло чаще отправлять заявку, однако бизнес получил меньше подходящих обращений. Статистическая проверка нужна для обеих оценок; сам расчёт уже показывает, почему выбор метрики меняет смысл «победы».
#Прирост, p-value и доверительный интервал отвечают на разные вопросы
После выбора метрики начинается другая работа: нужно понять, насколько точно измерена разница.
Абсолютный эффект — разность показателей. Если конверсия выросла с 2% до 2,2%, это плюс 0,2 процентного пункта.
Относительный эффект, uplift, — та же разница относительно контроля. В этом примере он равен 10%. Указывать только «+10%» опасно: читатель может представить себе прибавку в десять процентных пунктов.
p-value показывает, насколько необычным было бы наблюдаемое или более экстремальное различие при нулевой гипотезе и принятых допущениях расчёта. Обычно нулевая гипотеза — отсутствие эффекта изменения.
Значение p = 0,03 не означает, что с вероятностью 97% новая версия лучше. Оно также не означает, что вероятность случайности результата равна 3%. Американская статистическая ассоциация специально разбирает эти ошибки: p-value не измеряет вероятность истинности гипотезы, размер эффекта или его практическую важность.
Уровень значимости α — заранее выбранный предел ошибки первого рода для процедуры проверки. При α = 5% корректно устроенная проверка допускает до 5% ложных отклонений нулевой гипотезы в длительной серии экспериментов, где эта гипотеза верна. Это свойство процедуры, а не персональный «шанс ошибки» конкретного победителя.
Доверительный интервал эффекта показывает неопределённость оценки. Например, вместо одного «+8%» отчёт может дать диапазон от −3% до +19%. Данные пока совместимы и с небольшим ухудшением, и с существенным ростом.
У 95%-го частотного интервала точный смысл такой: при многократном повторении корректной процедуры примерно 95% построенных интервалов покрывают истинный эффект. Для практического чтения отчёта важны его положение и ширина: пересекает ли он ноль, насколько широк и где находится относительно эффекта, ради которого стоит внедрять изменение.
Сравнивать лучше интервал разницы между вариантами. Простое пересечение отдельных интервалов конверсии A и B не заменяет проверку разницы.
#Статистическая значимость ещё не окупает внедрение
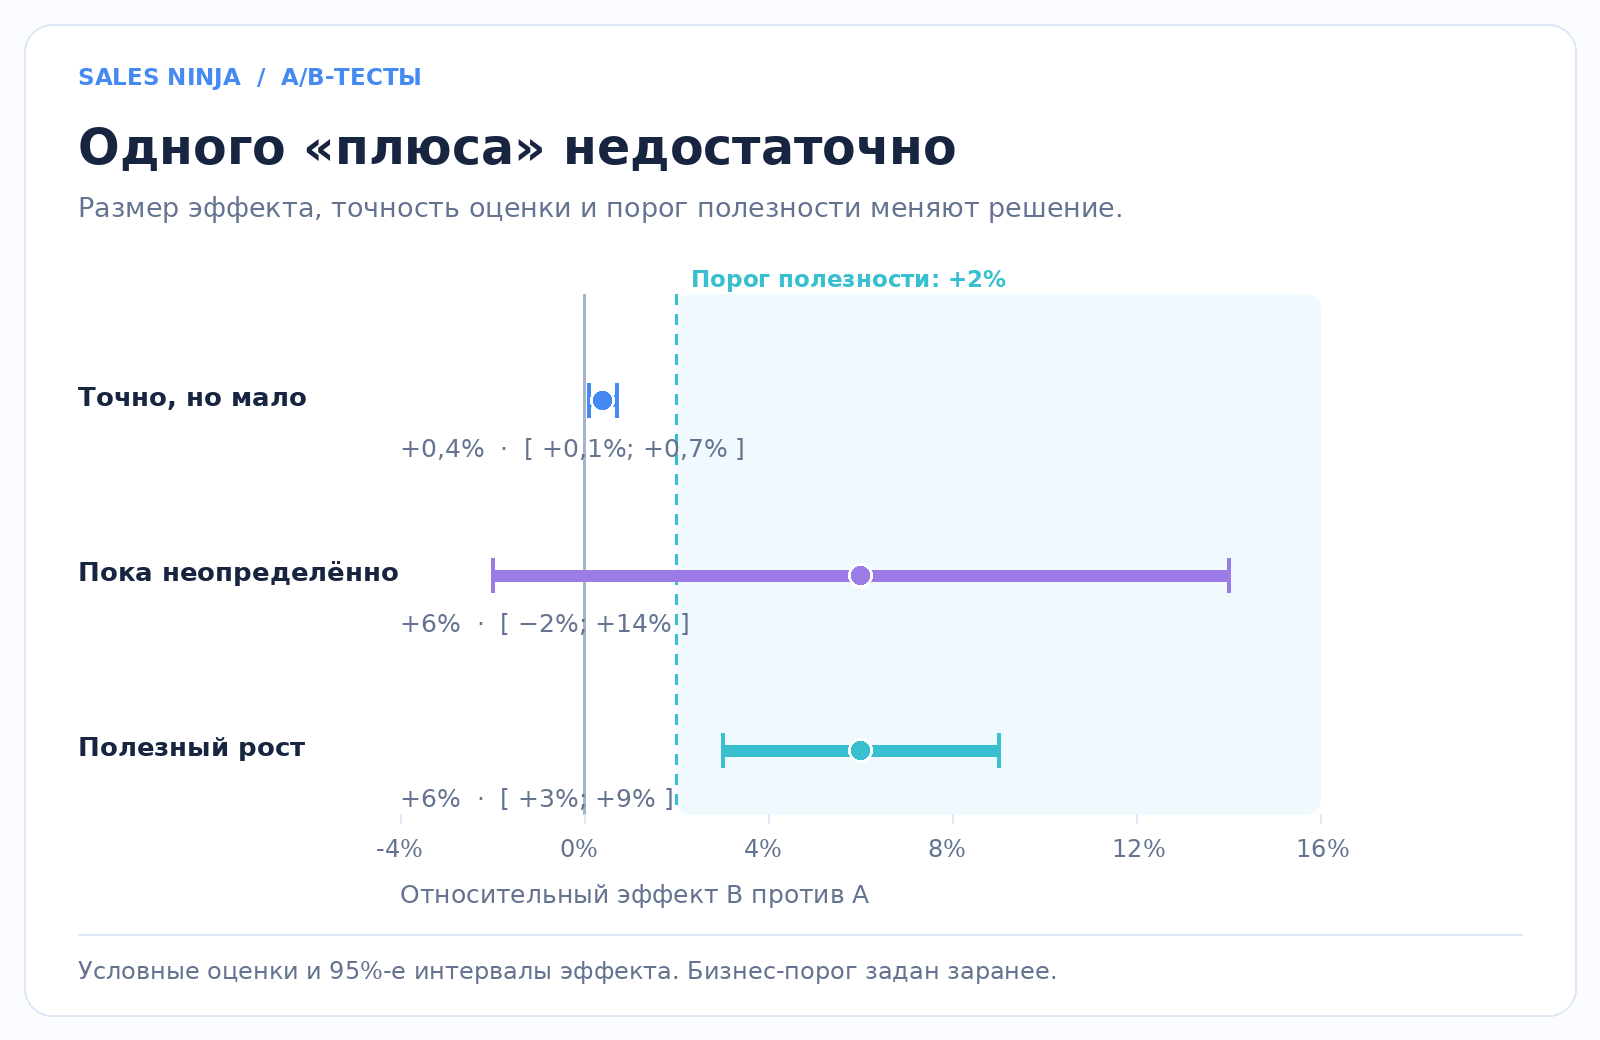
Условный результат: прирост выручки на пользователя составляет 0,4%, интервал — от +0,1% до +0,7%. Разница убедительно положительная. Но изменение требует дорогой разработки и дальнейшей поддержки, а окупается только при росте от 2%.
В другом тесте оценка составляет +6%, интервал — от −2% до +14%. Потенциал интереснее, однако риск ухудшения ещё не снят.
Первый эксперимент дал точный, но слишком маленький эффект. Второй дал потенциально полезный, но пока недостаточно точный. Для решения нужны оба измерения:** величина результата и неопределённость вокруг неё.**
#MDE и мощность: какого эффекта тест способен дождаться
На небольшом объёме трафика различимы только крупные изменения. Чем тоньше улучшение, тем больше данных нужно, чтобы отделить его от обычных колебаний.
MDE, minimum detectable effect, — минимальный эффект, для обнаружения которого спланирован эксперимент при заданных уровне значимости, мощности и объёме данных. MDE можно выражать в процентных пунктах, относительных процентах или денежных единицах — это нужно указывать явно.
Мощность, 1 − β, — вероятность обнаружить эффект выбранного размера, если он действительно существует и допущения расчёта выполнены. Часто тесты планируют с мощностью 80% или 90%. При мощности 80% эффект размера MDE примерно в одном случае из пяти останется невыявленным. Для меньшего эффекта мощность обычно ниже.
MDE не является жёсткой границей: эффект меньше MDE иногда обнаруживается, а эффект больше него иногда пропускается. Это характеристика чувствительности процедуры, а не обещание результата. Microsoft Research рассматривает MDE и мощность как часть чувствительности метрик.
Для масштаба возьмём расчёт двух независимых долей. Базовая конверсия — 2%, ожидаемая — 2,2%, относительный прирост — 10%. При равном распределении трафика, двусторонней проверке, α = 5% и мощности 80% стандартное нормальное приближение даёт около 81 тысячи пользователей на каждый вариант. Без поправки на дополнительные сравнения и без зависимых повторных наблюдений.
Если на эксперимент попадает всего 2 000 новых пользователей в день, собрать общий объём получится примерно за 81 день. Это уже заставляет пересмотреть замысел: укрупнить изменение, увеличить аудиторию или выбрать более чувствительный показатель, сохраняющий связь с бизнес-результатом.
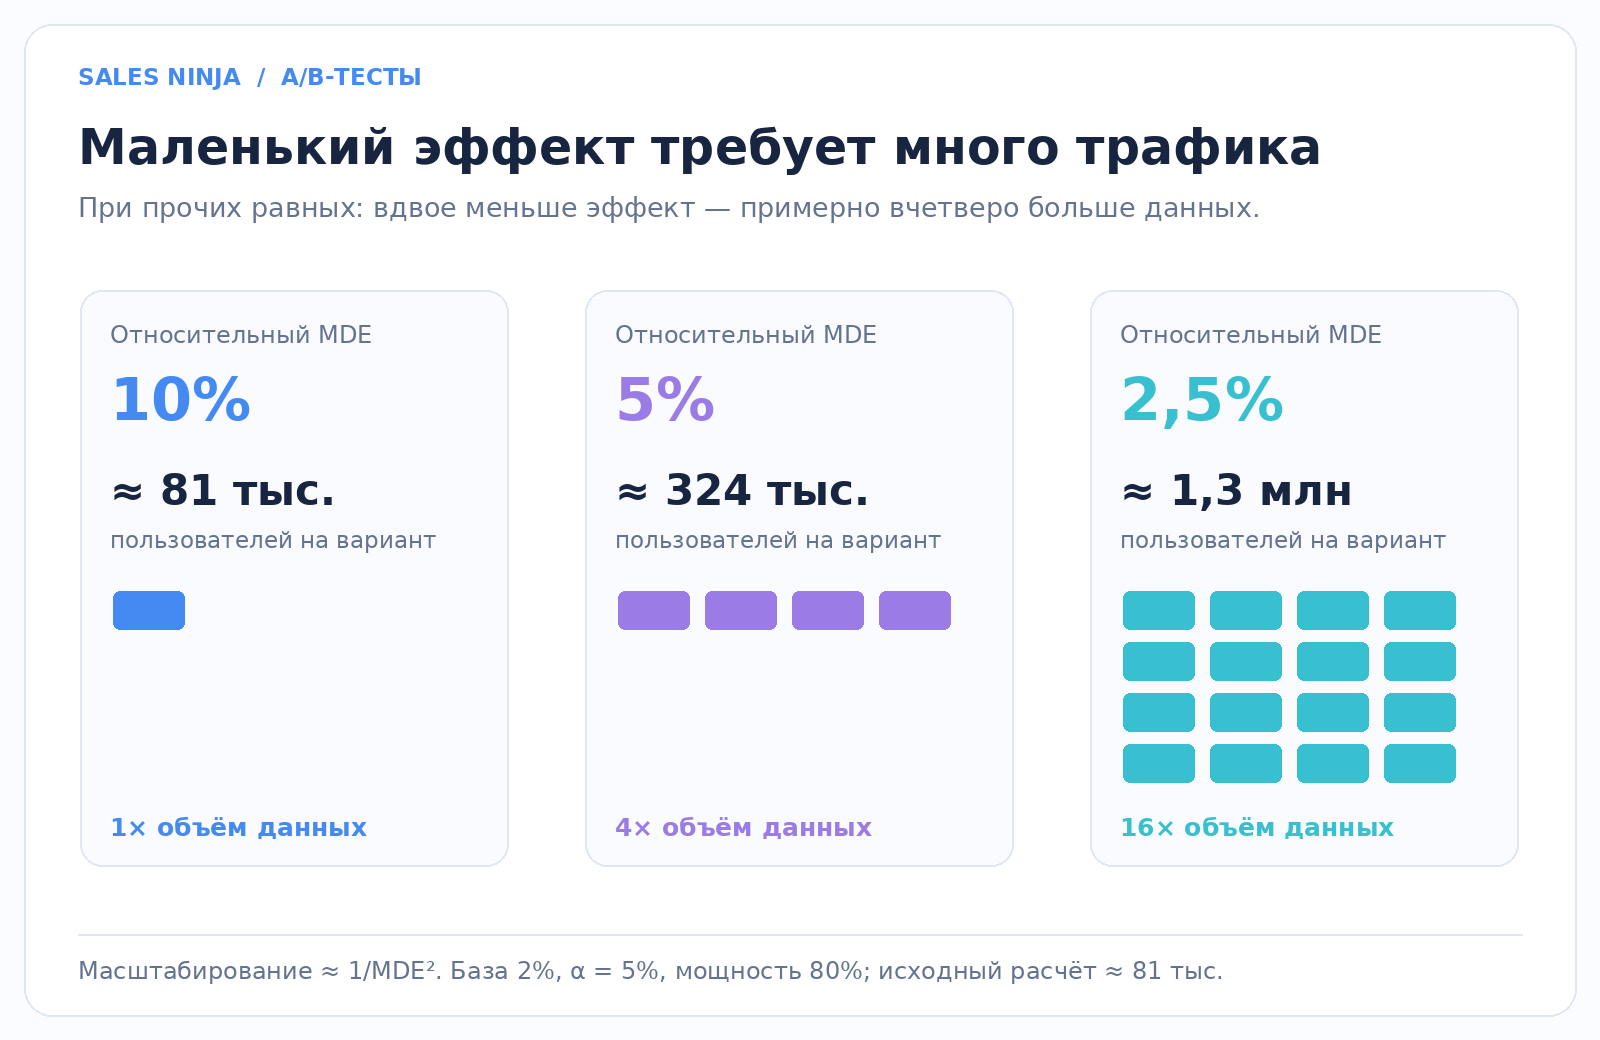
При прочих равных требуемый объём приблизительно растёт как обратный квадрат эффекта. Различить прирост вдвое меньше — значит собрать примерно вчетверо больше данных. Поэтому десятки вариантов при слабом трафике одновременно делят доступную выборку и повышают требования к доказательству.
До запуска стоит открыть бесплатный калькулятор A/B-теста Sales Ninja: задать базовую конверсию, число вариантов, полезный эффект и доступный трафик. Расчёт заранее покажет, соразмерны ли гипотеза и срок эксперимента.
#Почему «значимости нет» не равно «эффекта нет»
Если интервал широкий и пересекает ноль, тест мог просто не набрать достаточно данных. Продолжение имеет смысл, когда доступный трафик позволяет заметно сузить неопределённость.
Если же интервал узкий и целиком находится внутри заранее выбранного диапазона практически несущественных изменений, данные поддерживают вывод, что эффект мал. Для формального доказательства эквивалентности используют специальную проверку с заданными границами. Один p-value выше 0,05 такую проверку не заменяет.
#Поправки Бонферрони и Шидака: почему больше вариантов означает больше ложных побед
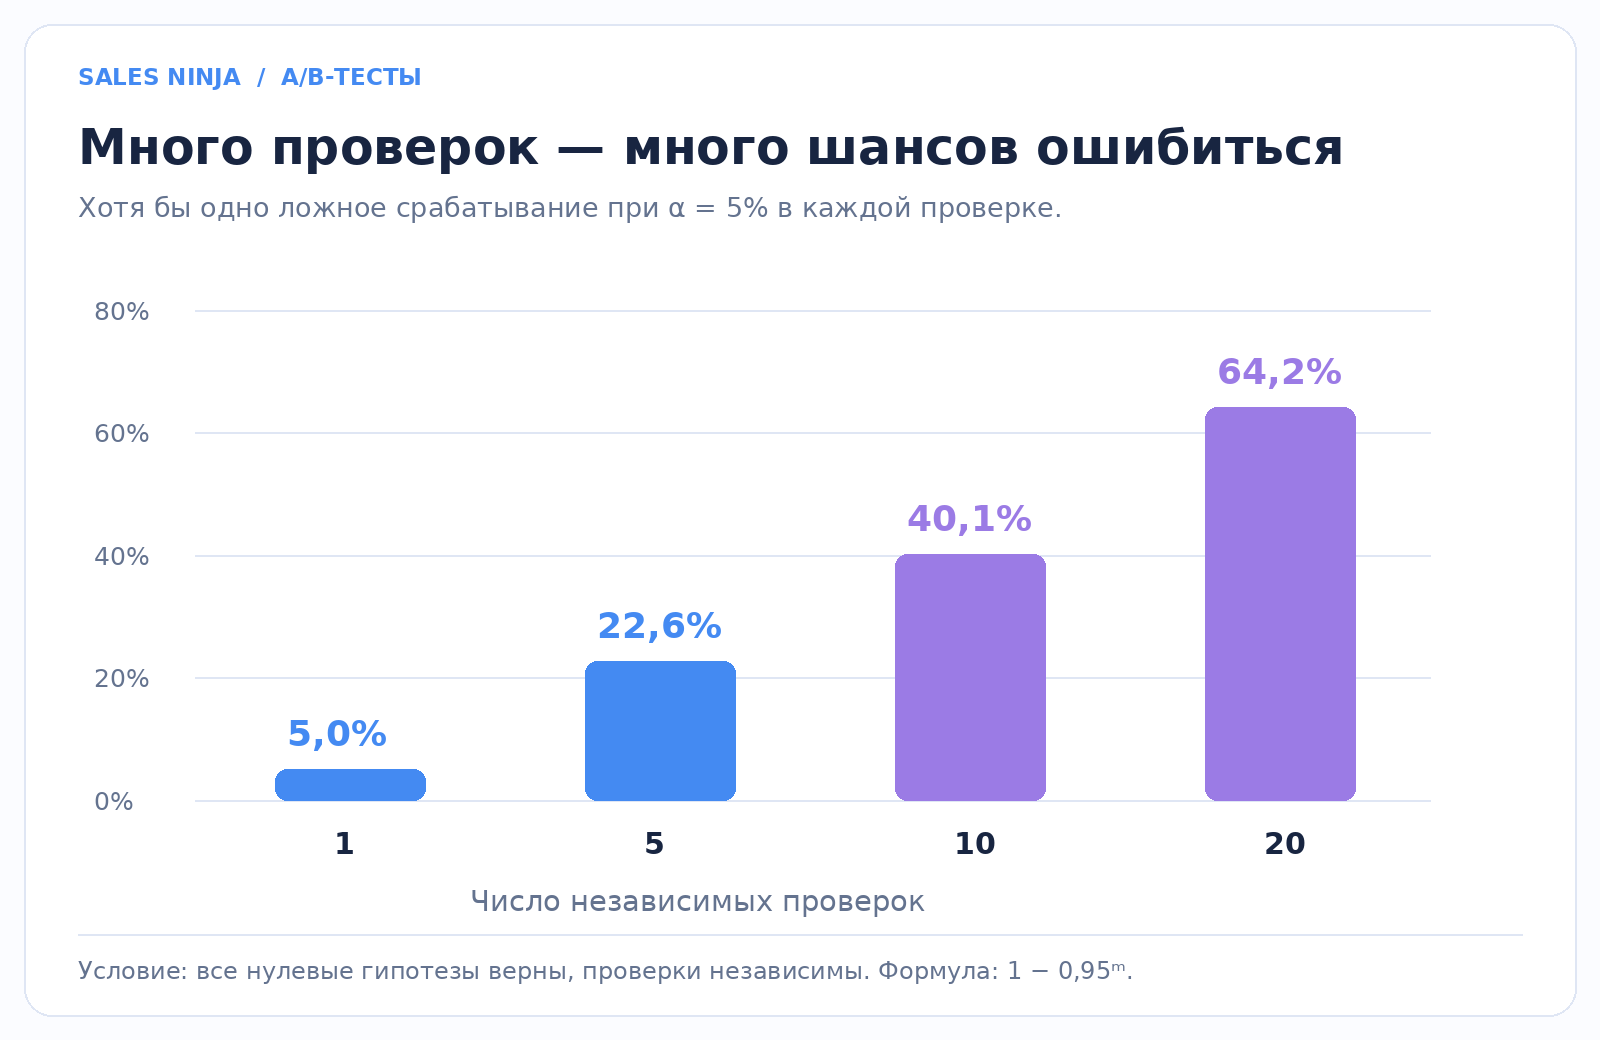
В одиночной проверке уровень значимости 5% выглядит умеренным. Но теперь представим двадцать независимых проверок, в каждой из которых реального эффекта нет.
Вероятность хотя бы одного ложного срабатывания равна:
1 − (1 − 0,05)²⁰ ≈ 64%.
Это условный расчёт для независимых проверок. Сравнения нескольких вариантов с общим контролем зависимы, поэтому точное число будет другим. Но сама проблема сохраняется: чем больше возможностей найти «значимый» результат, тем легче найти его случайно.
Она возникает не только при A/B/C/D-тестах. Один эксперимент можно превратить в десятки проверок, перебирая цели, устройства, города, источники трафика и сроки. Если после этого взять лучший результат и оценить его как единственную заранее выбранную гипотезу, уверенность окажется завышенной.
#Поправка Бонферрони
Поправка Бонферрони делит общий уровень значимости на число проверок:
α для одной проверки = α / m.
Для пяти сравнений и общего α = 5% каждое проверяют с порогом 1%. Это ограничивает вероятность хотя бы одного ложного отклонения в заранее определённой семье гипотез. При корректных отдельных p-value метод работает и для зависимых проверок.
Цена защиты — снижение мощности: для обнаружения того же эффекта обычно потребуется больше данных. Особенно заметно это при большом числе сравнений. Поэтому разумнее заранее выбрать небольшой набор вопросов, чем после запуска пытаться найти победу среди сотен сочетаний. В справочнике NIST показано, как Бонферрони сохраняет общий уровень доверия при нескольких сравнениях.
#Поправка Шидака
У поправки Шидака другой порог:
#α для одной проверки = 1 − (1 − α)^(1/m).
Для тех же пяти сравнений получается примерно 1,0206% вместо 1% по Бонферрони. Порог немного мягче. При независимых проверках формула точно соответствует заданной семейной ошибке; для зависимых проверок нужны дополнительные условия. Считать её универсальной заменой Бонферрони нельзя. В учебных материалах NTNU разобраны обе формулы и их допущения.
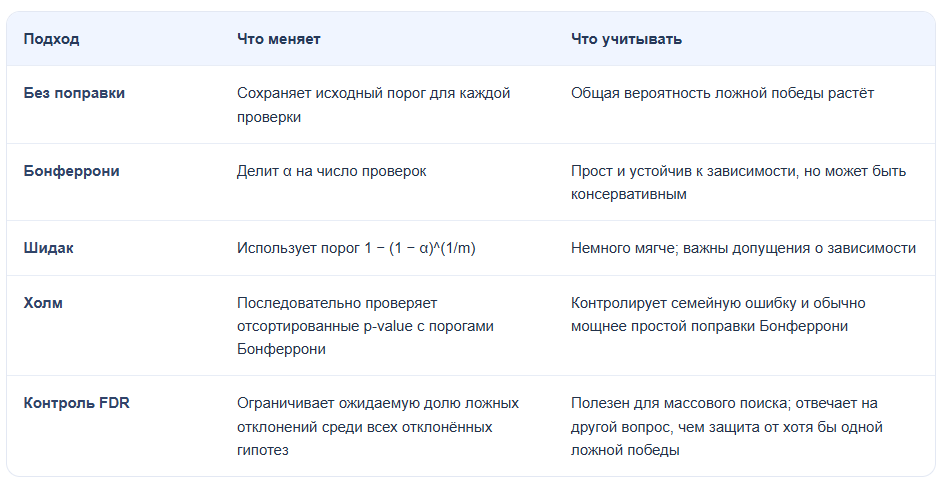
Эти методы входят в стандартный набор статистических процедур множественного тестирования. Выбор зависит от задачи: принять решение по конкретному варианту или искать перспективные направления среди большого числа гипотез.
Считать нужно проверки, а не названия вариантов. Пять новых вариантов против одного контроля — пять сравнений. Все попарные сравнения между шестью вариантами — уже пятнадцать. Просмотр нескольких метрик и сегментов добавляет другие гипотезы. Нельзя считать, что одна поправка по вариантам автоматически защищает любой дальнейший поиск в отчёте.
#Досрочная остановка: отдельная причина ложного результата
Даже тест с одним вариантом против контроля можно испортить ежедневным правилом: «увидели p < 0,05 — выключаем».
Разница колеблется по мере накопления данных. Если дать шуму много возможностей пересечь порог и остановиться в удачный момент, обычная проверка с фиксированной выборкой перестаёт обеспечивать заявленный уровень ошибки. Поправка по числу вариантов сама по себе этот сценарий не исправляет.
У команды есть два рабочих подхода.
Фиксированный объём: заранее определить выборку и условия завершения, а решение об успехе принять в предусмотренной финальной точке. По ходу можно следить за поломками и серьёзным ущербом.
Последовательный анализ: заранее выбрать метод, который допускает промежуточные проверки и учитывает их при принятии решения. В групповых последовательных схемах вроде O’Brien–Fleming ранние границы строже: для досрочной победы нужен особенно убедительный сигнал.
В обоих случаях нужно учитывать деловой цикл и задержку целевого действия. Формально достаточная выборка за два дня может не описывать поведение выходных, возвратных пользователей или сделок, созревающих неделями.
#А байесовский анализ решает эту проблему?
Байесовский отчёт может показывать вероятность того, что B лучше A, и ожидаемые потери от выбора варианта. Эти величины рассчитываются в рамках выбранной модели и априорных предположений. Они ближе к формулировке бизнес-решения, чем p-value, но требуют собственной политики остановки и оценки риска.
Вероятность P(B > A) = 95% не равна мощности 95% или частотному уровню значимости 5%. И она не обязательно означает, что рост достаточно велик для внедрения: полезнее бывает оценивать вероятность превышения конкретного бизнес-порога.
#Что ещё может испортить A/B-тест
#Перекос распределения трафика — SRM
Если распределение задано 50/50, а наблюдаемое соотношение систематически расходится с ожидаемым сильнее случайных колебаний, нужно искать причину. Это называется sample ratio mismatch, SRM.
Одна версия может не применяться на части устройств, события могут теряться после редиректа, а условия включения — по-разному отсекать пользователей. Статистически значимый прирост на таких данных способен описывать ошибку сбора. Microsoft рассматривает SRM как признак проблем с качеством данных: до их устранения выводам теста нельзя доверять.
При многоруком бандите или заранее неравных долях трафика сравнивают фактическое распределение с предусмотренным политикой, а не с абстрактными 50/50. Само неравенство групп ошибкой не является.
#Повторные визиты и неверная единица анализа
Десять визитов одного человека не дают столько же независимой информации, сколько визиты десяти разных людей. Если вариант закреплён за пользователем, расчёт неопределённости должен учитывать зависимость его сессий.
Это не запрещает измерять выручку на сессию. Но оценку ошибки нужно строить с учётом единицы рандомизации — например, агрегировать наблюдения или применять методы, учитывающие группировку по пользователю. Иначе интервал получится слишком узким.
#Незрелые конверсии
В недвижимости, автомобилях и B2B отправка формы происходит быстро, а квалификация или сделка — значительно позже. Участник, пришедший вчера, ещё не получил столько времени на конверсию, сколько участник первой недели.
Нужно заранее определить окно результата и одинаково учитывать его в обеих группах. Особенно опасно принять ускорение события за рост его итоговой вероятности: одна версия может получать заявки быстрее, но не больше за полный срок.
###Выручка с длинным хвостом Большинство пользователей ничего не покупает, а несколько крупных заказов меняют среднее. Двух чисел — посетителей и общей выручки — недостаточно, чтобы узнать разброс результата.
Нужны данные о вариативности и подходящий метод оценки. Правила работы с выбросами, возвратами и отменами задают заранее. Удалять крупный заказ только потому, что он «испортил значимость», значит подгонять анализ под желаемый ответ.
#Срезы после воздействия и поиск удачного сегмента
Устройства, география и история до теста могут объяснять различия. А сравнение только тех, кто после изменения дошёл до оплаты, уже отбирает людей по поведению, на которое повлиял сам вариант.
Есть и другая ловушка: B оказался значимым на мобильных, но незначимым на десктопе. Это ещё не доказывает, что эффекты между устройствами различаются — нужна проверка самого различия эффектов. Найденный после просмотра множества срезов сегмент разумно считать гипотезой для следующего теста или анализировать с учётом множественного поиска.
#Боты, ошибки измерения и пересечение экспериментов
Ботные визиты, повторная отправка событий, разные правила атрибуции и потеря идентификатора между сайтом и CRM меняют измеряемый результат. A/A-проверки и контроль качества событий помогают обнаружить проблемы до проверки новой гипотезы.
Параллельные тесты тоже требуют решения: независимо рандомизированные изменения могут сосуществовать, но взаимодействия между ними меняют смысл среднего эффекта. Если два эксперимента затрагивают одну форму или цену, стоит развести аудитории либо специально спланировать проверку сочетаний.
#Как всё это устроено в Sales Ninja
Когда команда регулярно проводит эксперименты, ручная сборка расчётов становится отдельной работой: выбрать метрику, проверить данные, учесть варианты, дождаться нужной выборки и сохранить понятное правило остановки.
В Sales Ninja для A/B-тестирования эти возможности собраны в одном сервисе. Можно выбирать конверсии, выручку или прибыль; задавать аудиторию и варианты; смотреть эффект в статистике; управлять завершением эксперимента и защитой важных показателей.
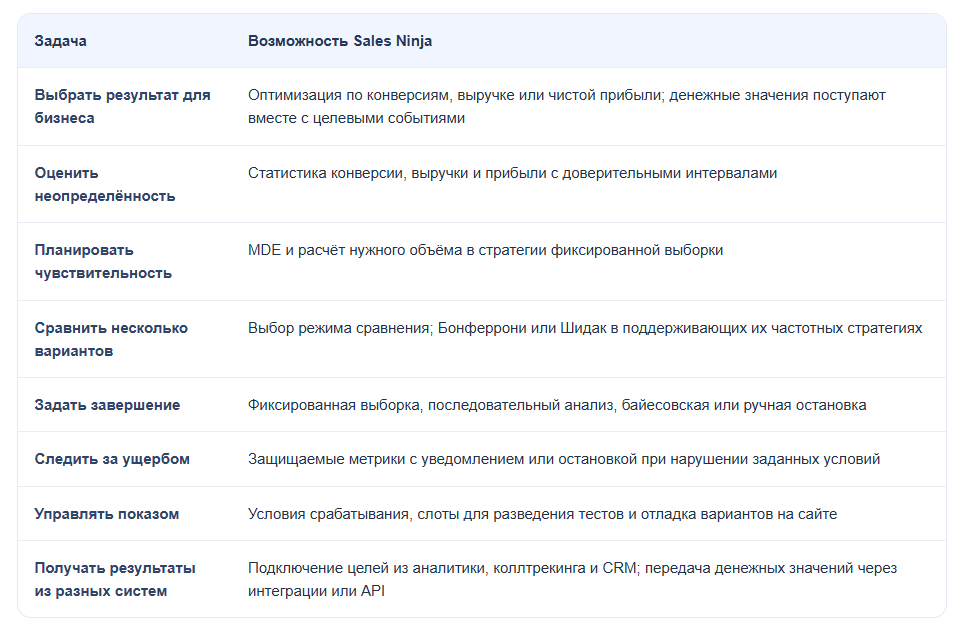
Конкретные настройки описаны в документации: создание теста, правила остановки, множественные сравнения и защищаемые метрики.
Поправки Бонферрони и Шидака доступны в стратегиях фиксированной выборки и последовательного анализа. В байесовском режиме используются другие правила оценки. Для защитных правил доступны отказность, конверсия, выручка и чистая прибыль на сессию; их нужно включить под риски конкретного теста. Такая конфигурация позволяет согласовать метод с задачей, вместо применения одного критерия ко всем экспериментам.
Есть и многорукий бандит: он перераспределяет трафик между вариантами по накопленным результатам. Это помогает управлять показом во время эксперимента. При адаптивном распределении и статистический анализ должен учитывать выбранную политику; механически переносить расчёт из обычного теста с фиксированными долями нельзя.
При редких или отложенных конверсиях можно использовать моделируемый сигнал для оптимизации. Его роль — раньше дать информацию о предполагаемой ценности визита. Доказательство прироста реальных продаж, выручки или прибыли всё равно требует наблюдаемого бизнес-результата: улучшение прогноза и улучшение продаж — разные выводы.
До запуска определите полезный эффект, основную метрику, ограничения по ущербу и срок созревания результата. Затем проверьте, хватает ли трафика, и выберите правило завершения. Если это сделано заранее, отчёт отвечает на исходный вопрос команды. Если правила меняются после каждого нового графика, даже продвинутая статистика начинает обслуживать поиск удобного ответа.
Начать можно с бесплатного A/B-калькулятора. Для регулярных экспериментов с несколькими вариантами, бизнес-метриками и управляемой остановкой — посмотрите возможности A/B-платформы Sales Ninja.